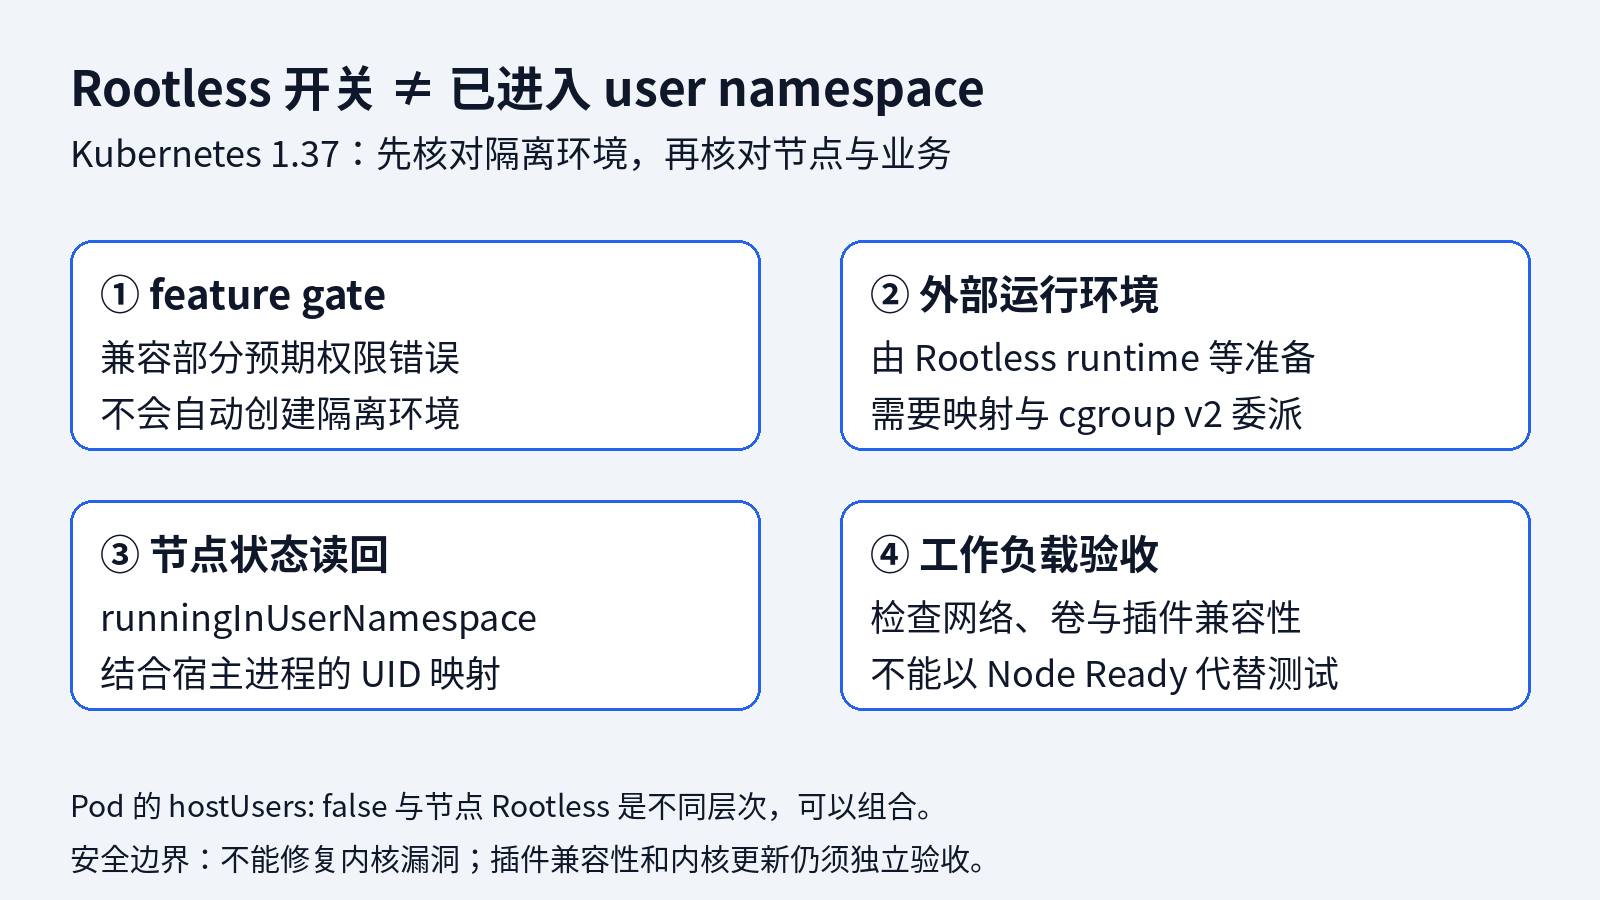
把 KubeletInUserNamespace 设成 true,kubelet 却还以宿主机 root 运行,配置没生效吗?不一定。这个开关不会自动创建隔离环境。本文面向 Linux 节点,按“开关、运行环境、节点状态、业务兼容”四层排查,避免把配置成功误当成 Rootless 成功。
一、先把三种“非 root”分开
容器的 runAsNonRoot 约束工作负载用户;Pod 的 hostUsers: false 使用 Pod user namespace;节点 Rootless 则把 kubelet、运行时等节点组件放进 user namespace。它们处理的对象不同,不能互相代替。
Kubernetes 2026 年 9 月 4 日官方公告确认:KubeletInUserNamespace 在 1.37 进入 Beta,默认开启。这里以该变化解释长期排查方法,并非把旧公告当成当天发布的新闻。现有 Rootful 集群不会因为升级就自动转换身份。
二、开关究竟做了什么
Linux user namespace 能把 namespace 内的 UID 映射为外部不同 UID。里面看见 UID 0,不等于拥有宿主机初始 namespace 的 root 权限。映射、可写 cgroup 树和网络环境,需要由外部运行时或部署工具准备。
这个 feature gate 主要让 kubelet 容忍部分预期权限错误,例如设置某些 sysctl 或读取 /dev/kmsg 失败。它不是自动降权按钮,更不会替你把正在运行的服务搬到另一个 namespace。门牌换了,房子不会自己搬家。
安全收益是缩小部分节点组件逃逸后的影响范围,不是隔离所有风险。它不能修复内核漏洞;运行账号可读写的目录、挂载和凭据仍须限制,内核更新与 seccomp 等防护也不能省。
三、先检查宿主条件,别急着改 kubelet
官方节点组件方案要求 cgroup v2、systemd 用户会话、UID/GID 子范围及相应委派。下面在拟用于部署的普通用户会话中运行;不是先用 root 执行一遍就算验收:
id -u
stat -fc %T /sys/fs/cgroup
systemctl --user is-system-running
grep -E "^($(id -un)|$(id -u)):" /etc/subuid /etc/subgid
第一项不应为 0;文件系统类型期望是 cgroup2fs。用户 manager 返回 degraded 时应查失败单元,而不是直接判定整个部署不可用。子范围列表为空要先补分配;缺文件则按发行版方案排查。这里展示文件配置检查,采用其他 subid 后端的环境要核对对应后端。
这些只是必要线索。cgroup2fs 不能证明委派完成,子范围存在也不能证明当前进程已经使用映射。不要为图省事直接关闭 SELinux 或批量放宽宿主权限。
四、选部署路径,而不是复制整段配置
新建测试环境可按官方建议使用 kind 配合 Rootless Docker、Podman 或 nerdctl。先依照运行时文档完成普通用户安装,再确认当前 Docker context 与服务端信息,防止客户端仍连向系统级 daemon:
docker context show
docker info --format '{{json .SecurityOptions}}'
docker info --format '{{.CgroupVersion}}'
检查 SecurityOptions 中的 rootless 标记以及 cgroup 版本;仅 context 名称叫 rootless 不够。客户端环境变量或命令参数可能改变实际连接目标。确认使用的是 Rootless 服务端后,再按 kind 官方文档选择兼容节点镜像创建测试集群。
已有生产节点应先建测试节点,再评估迁移。手工部署文档的 cgroupfs 示例有特定前提:systemd 在外部委派,namespace 内没有另一个 systemd 管理它。不要复制成通用建议。
五、用节点字段和宿主映射交叉验证
在具备相应字段的版本上,可以先读节点信息:
kubectl get nodes -o custom-columns='NAME:.metadata.name,KUBELET:.status.nodeInfo.kubeletVersion,USERNS:.status.nodeInfo.runningInUserNamespace'
kubectl get nodes -o wide
字段为 true 是节点侧证据;字段缺失不是 false,先核对 kubelet 版本和 API 返回。不同节点可能不同状态,不能抽一台就宣布全集群 Rootless。
然后在实际宿主机查目标 kubelet 进程,避免在嵌套容器里看错 PID。用下面命令列候选,再把下一段的 12345 换成核实后的 PID:
ps -eo user,pid,comm | grep -E 'kubelet|containerd|crio'
PID=12345
readlink "/proc/$PID/ns/user"
readlink /proc/1/ns/user
cat "/proc/$PID/uid_map" "/proc/$PID/gid_map"
namespace 标识不同只说明边界不同,还要结合 UID/GID 映射、进程身份和父级关系解释。观察命令因权限失败时,应由有权限的管理员读回,不能靠猜测补结果。
六、故障分支:按证据决定下一步
| 现象 | 优先检查 | 处理方向 |
|---|---|---|
| 开关为 true,进程仍是宿主 root | 实际启动方式、namespace、映射 | 准备外部 Rootless 环境,不是反复切开关 |
| cgroup 权限错误 | v2、用户 manager、委派 | 按运行时文档修复前置条件 |
| Node Ready,但业务连不通 | CNI、Service、端口转发 | 分别验证集群内部与宿主入口 |
| Pod 卡在卷挂载 | CSI、卷类型、插件权限 | 查插件支持范围,保留对照环境 |
官方文档列出 NFS、iSCSI 等非本地卷驱动的限制,部分 CNI 也不适配。不能把“Flannel VXLAN 已知可用”理解为所有网络或存储插件都能平移。10250 与 NodePort 等入口在不同部署路径下也可能需要额外转发。
七、最后验收的是业务,不只是节点
- 每台目标节点都留存版本、user namespace 与身份映射证据。
- 以 emptyDir、ConfigMap 等基础工作负载验证读写,再测实际使用的 CSI、网络和设备插件。
- 验证 DNS、Service、入口流量、日志采集和监控;别只看 Pod Running。
- 按已确认兼容性设置节点标签、污点和调度策略,不把需要真实宿主权限的任务盲目迁过去。
- 在测试环境验证重启与回滚;数据卷需要独立备份,恢复 Rootful 节点不等于恢复数据。
本文命令用于配置观察和诊断,没有在真实 Kubernetes 集群执行部署验证,不能作为特定发行版的成功记录。Rootless 是否落地,取决于真实运行边界;开关值只是证据链的起点。
八、参考资料
事实核对以以下官方材料为准:1.37 Rootless Beta 公告、非 root 节点组件部署文档、运行时与 cgroup driver 说明。首次部署还需对照所选运行时及 kind 的官方 Rootless 指南,不把本文诊断命令当成完整安装步骤。
🔕 评论已关闭