升级 Kubernetes 后,节点突然变成 NotReady,kubelet 日志里还出现 cgroup v1、driver 不匹配或资源限制异常,这类问题往往不是 Pod 配置写错,而是 Linux、container runtime 和 kubelet 没有使用同一套 cgroup 口径。Kubernetes 官方在 2026 年 10 月 6 日再次提醒:cgroup v1 已进入淘汰路径,较新的集群应把迁移当成节点级工程,而不是只改一行 kubelet 配置。本文给一套不碰业务 Pod 的检查、迁移和验收顺序。
1. 先分清:这是资源接口迁移,不是简单开关
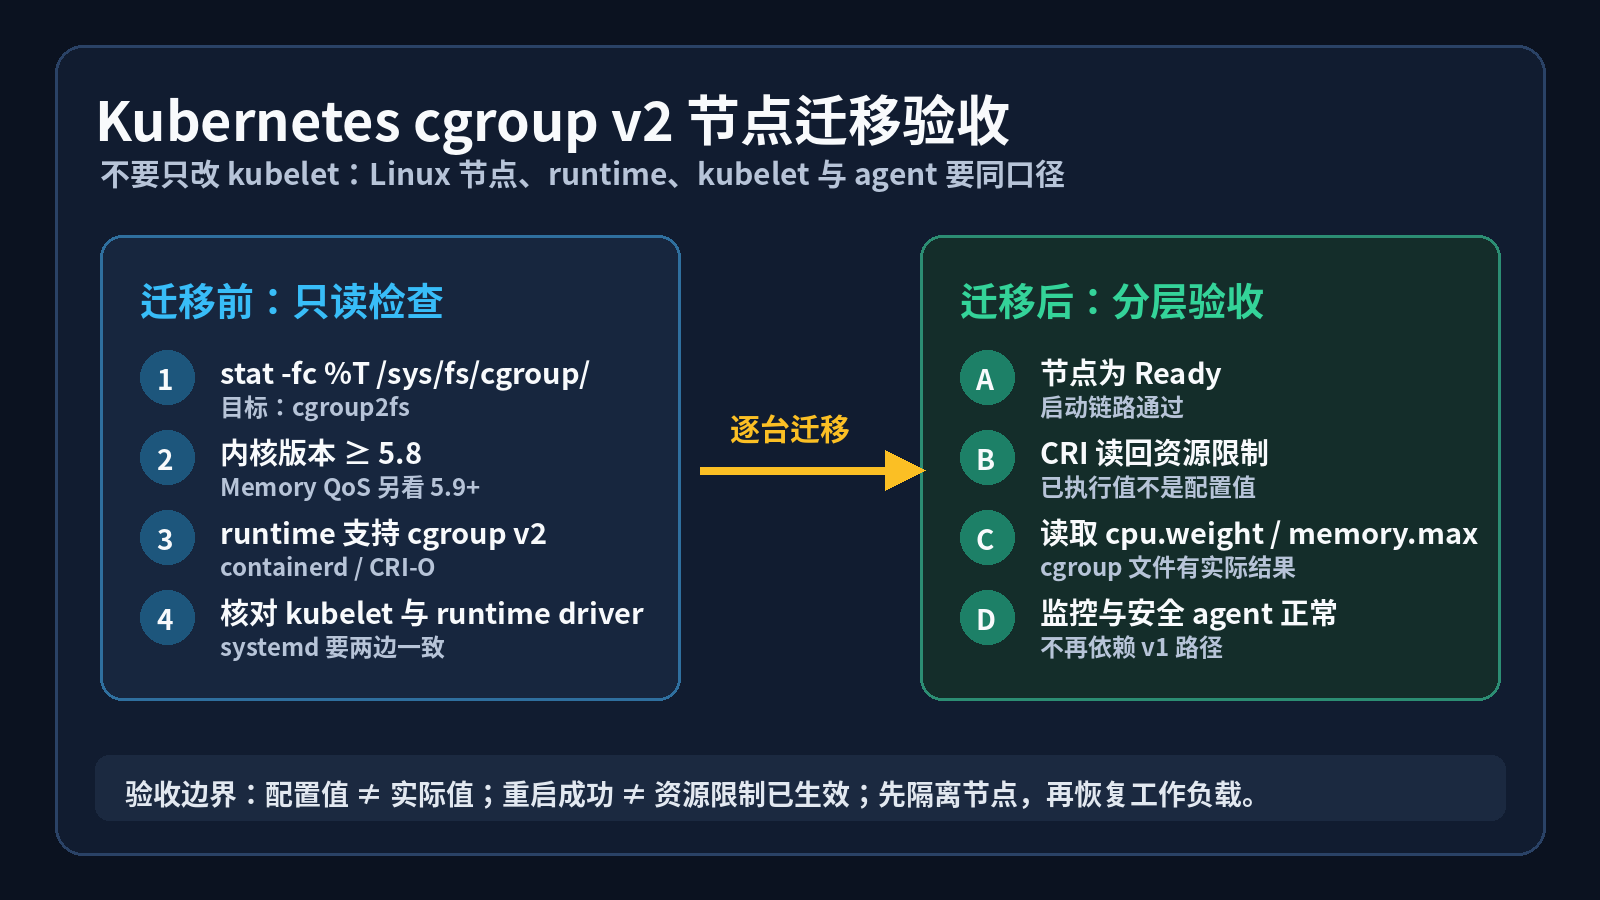
cgroup 是 Linux 对进程做 CPU、内存和进程数隔离的内核接口。cgroup v2 使用统一层级,Kubernetes 文档标记为 v1.25 起稳定,并支撑部分更现代的资源管理能力。迁移时至少有四个对象要对齐:Linux 内核和挂载方式、container runtime、kubelet 的 cgroup driver,以及直接读取 cgroup 文件的监控或安全 agent。
最容易踩的坑是“节点已经启用 v2,所以 kubelet 肯定没问题”。实际上,节点可能是 v2,containerd 却仍按旧 driver 工作;也可能 kubelet 能启动,但独立 cAdvisor、Java 或 Node.js 组件仍读取 v1 路径。先看事实,再改配置,别让 kubelet 当探路车。
2. 在每台 Linux 节点做三项只读检查
以下命令只读取节点状态。先把输出保存到变更记录,不要直接在生产节点上反复重启服务:
# 1) 确认 cgroup 版本:v2 应输出 cgroup2fs
stat -fc %T /sys/fs/cgroup/

# 2) 确认 v2 控制器是否存在
cat /sys/fs/cgroup/cgroup.controllers

# 3) 确认内核版本
uname -r
Kubernetes 文档给出的 cgroup v2 内核最低版本是 5.8;如果要使用依赖 memory.high 的 Memory QoS,官方文章建议关注 5.9 及以上的内核能力。命令输出为 tmpfs 时,不要把它当作 v2:这通常说明当前挂载仍是 cgroup v1。
这里的“最低版本”只针对 cgroup v2 的 Kubernetes 要求,不等于你的发行版、网卡驱动或安全软件都支持升级。老内核即使能勉强启动,也不应直接当成生产迁移完成。
3. kubelet 与 runtime 必须使用同一个 driver
使用 systemd 作为 init system 时,Kubernetes 推荐 kubelet 和 container runtime 都使用 systemd driver。kubeadm 管理的集群尤其要遵循这一点。kubelet 配置示例:
apiVersion: kubelet.config.k8s.io/v1beta1
kind: KubeletConfiguration
cgroupDriver: systemd
containerd 的 CRI 配置通常位于 /etc/containerd/config.toml,关键项应是:
[plugins."io.containerd.grpc.v1.cri".containerd.runtimes.runc.options]
SystemdCgroup = true
不同发行版可能使用不同配置路径,不能只凭文件存在就判定生效。读取实际进程和 CRI 返回值更可靠;如果集群启用了 Kubernetes 1.34 稳定的 KubeletCgroupDriverFromCRI,且 runtime 支持 RuntimeConfig,kubelet 可能使用 runtime 报告的 driver,而忽略配置文件中的值。这个自动发现减少了漂移,但没有替你升级 runtime。
4. 迁移顺序:先做一台节点,再扩散
建议按“验证镜像和 agent—隔离节点—迁移—恢复调度—观察”的顺序执行:
- 从节点池挑一台可回滚节点,记录 Kubernetes、内核、containerd、runc 和 cAdvisor 版本。
- 确认监控、安全 agent 和自研程序没有硬编码
/sys/fs/cgroup的 v1 文件名;独立 cAdvisor 至少升级到官方文档要求的 v0.43.0 或更高版本。 - 排空节点并设置不可调度,按发行版文档启用 cgroup v2。不要把 GRUB 参数直接复制到不同发行版,先确认启动加载器和回滚方式。
- 让 container runtime 与 kubelet 的 driver 同步为 systemd,再按变更窗口重启节点服务。
- 节点回到 Ready 后,只恢复一小部分工作负载,观察 OOM、CPU throttling、采集器错误和业务延迟。
迁移不是“重启成功就结束”。新节点能启动,只证明启动链路暂时过了;资源限制是否真的落到容器 cgroup,还需要单独验收。
5. 节点起不来时,按日志分支处理
| 现象 | 优先检查 | 处理方向 |
|---|---|---|
failCgroupV1 或 v1 节点拒绝启动 | stat 输出和内核启动参数 | 迁移节点到 v2;临时兼容开关只作为升级过渡,不当长期方案 |
| driver mismatch | kubelet 配置与 runtime 实际 driver | 统一为 systemd,重启对应服务并重新读回 |
| Pod 限制不生效 | Pod 资源、CRI 信息、cgroup 文件 | 检查 runtime、runc 及监控 agent 的 v2 兼容性 |
| 监控指标消失 | agent 是否读取 v1 路径 | 升级 agent,不要为了旧采集器长期退回 v1 |
诊断时可以先看 kubelet 日志和节点状态:
journalctl -u kubelet -b --no-pager | grep -Ei 'cgroup|driver|failCgroupV1'
kubectl get nodes -o wide
kubectl describe node <node-name> | grep -Ei 'Ready|cgroup|runtime'
failCgroupV1: false 是临时兼容路径,不是“问题已解决”。官方迁移说明明确建议规划迁移;把兼容开关永久留在配置里,等于把升级债务藏进启动命令。
6. 资源验收要同时看期望值和实际值
选一个无状态测试工作负载,在隔离节点上设置明确的 CPU、内存 request/limit,然后从三个层面核对:Pod 的 spec.containers[*].resources 是期望值,CRI 或 kubelet 的容器状态是已执行值,最后再看对应 cgroup 的 cpu.weight、cpu.max 和 memory.max。使用 Memory QoS 时,再检查 memory.high、memory.min 或 memory.low 是否符合启用条件。
不要只看 kubectl describe pod 里配置有没有显示,也不要把一次 OOM 事件直接解释成 cgroup v2 故障。资源规格、内核限制、runtime 映射和业务行为是四件事,应该分别留下证据。
7. 回滚边界与验收清单
回滚前先确认旧节点是否仍可用、旧镜像和 agent 是否兼容,并保留 kubelet、runtime、内核和启动参数的变更前副本。回滚的目标是恢复服务,不是掩盖不兼容项;每次只回退一个变量,避免最后只剩一句“重启后好了”。
- 每台节点
stat -fc %T /sys/fs/cgroup/的结果符合目标版本。 - 内核、container runtime、kubelet 和 cgroup driver 版本及配置已记录。
- kubelet 与 runtime 的 driver 一致,节点为
Ready。 - 测试 Pod 的 CPU、内存限制在 CRI 与 cgroup 文件中都能读到。
- cAdvisor、Java、Node.js 及安全 agent 的 v2 兼容性已核对。
- 异常日志、回滚入口和观察窗口已写入变更单。
把 cgroup v2 迁移看成“节点运行时契约”更准确:Linux 提供接口,runtime 负责映射,kubelet 负责编排,监控和应用还要能读懂结果。四者一起验收,节点才是真的 Ready;只改一行配置,通常只是把问题换了个日志位置。
🔕 评论已关闭