Python 升级后,旧报表突然报 UnicodeDecodeError,先别把锅甩给文件损坏。Python 3.15 默认启用 UTF-8 模式;过去依赖本地编码的文本读取,可能换了“解释字节”的规则。本文用隔离文件区分默认编码、真实文件编码与显式转码,保留原件,不靠忽略错误假装修好。
一、这次变化改的是默认值,不是旧文件
Python 官方于 2026 年 10 月 9 日发布 3.15.0,公告列出 PEP 686:UTF-8 模式默认开启。PEP 与 io 文档共同确认这项变化。它不是“所有文件自动变成 UTF-8”,也不是 GBK 解码器被移除;磁盘字节不会因解释器升级而重写。
风险集中在没写 encoding 的 open(path) 与 Path.read_text()。原来在非 UTF-8 环境能读,升级后可能失败;原来已经用 UTF-8,则未必有症状。
二、先确认运行环境,别只看编辑器
把下面保存为 probe.py,用实际运行业务的解释器执行。此诊断脚本需要 Python 3.11+,因为 locale.getencoding() 从 3.11 才提供。UTF8模式为 1 表示开启;locale 编码与文本默认编码并不总是同一个值,这个 API 特意忽略 UTF-8 模式。
import sys, locale, json
print(json.dumps({
    "版本": sys.version.split()[0],
    "UTF8模式": sys.flags.utf8_mode,
    "locale编码": locale.getencoding(),
    "标准输出编码": sys.stdout.encoding,
}, ensure_ascii=True))
开发终端与服务进程可能使用不同解释器,应分别采样。stdout 编码描述输出流,不能判断 CSV 磁盘编码。
三、用一份已知 GBK 文件复现问题
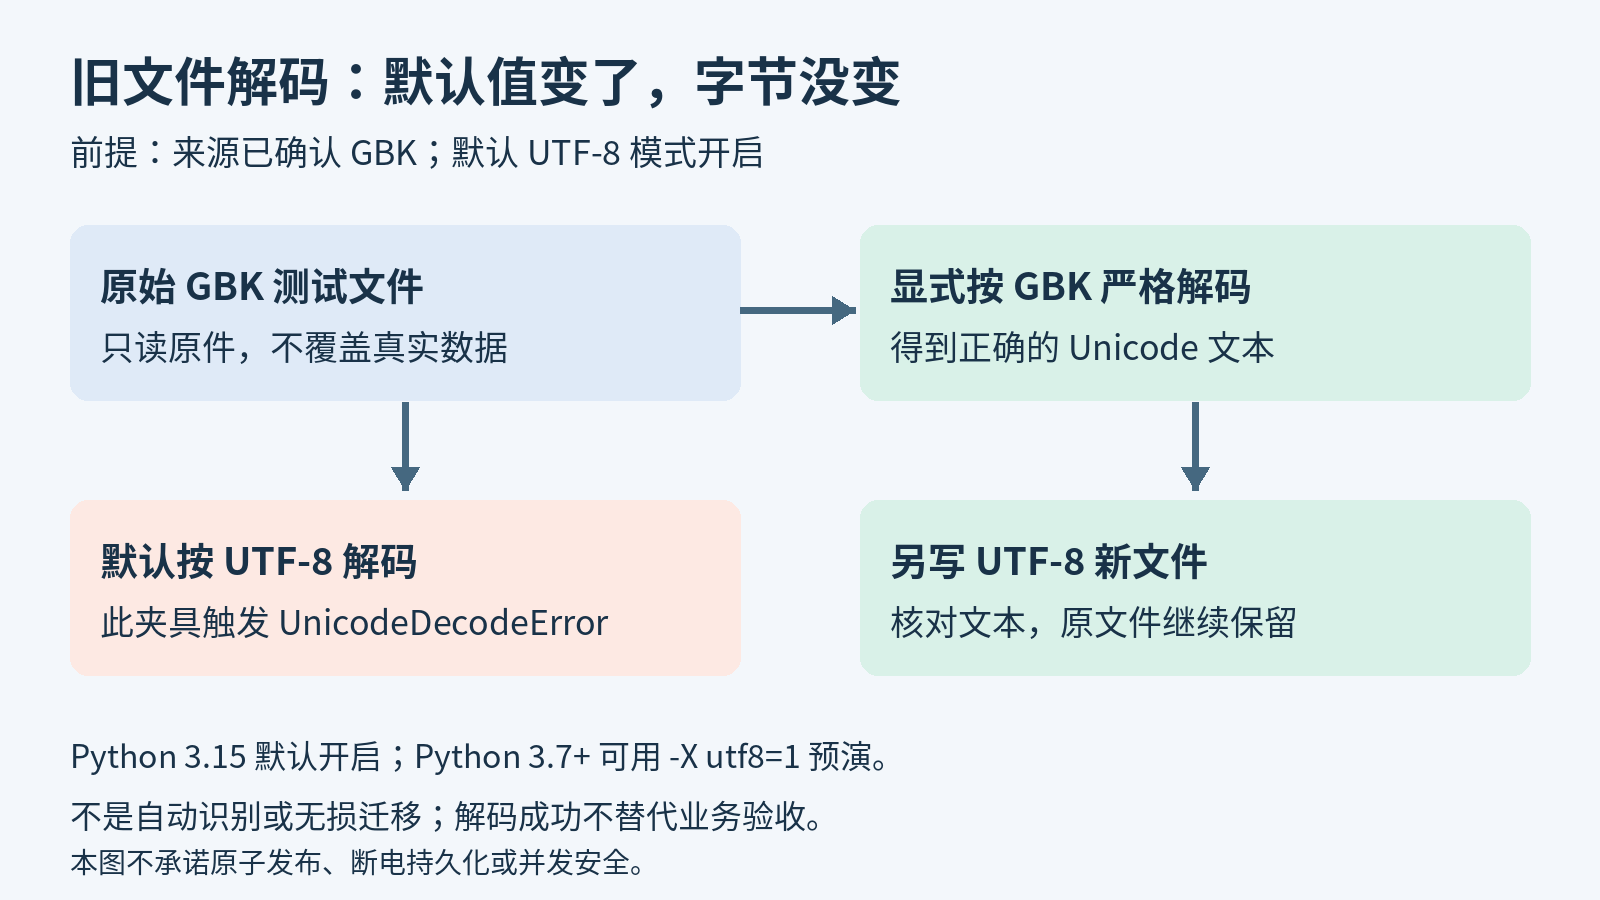
下面保存为 fixture.py。它只在临时目录制造测试文件,不读取真实账单或生产配置。显式用 UTF-8 读已知 GBK 数据会失败,改用 GBK 能恢复原文;这说明问题在解码规则,不等于现实中的任意报错文件都是 GBK。
from pathlib import Path
from tempfile import TemporaryDirectory
with TemporaryDirectory() as 目录:
    文件 = Path(目录) / "legacy.txt"
    文件.write_bytes("茶叶,12\n".encode("gbk"))
    try:
        文件.read_text(encoding="utf-8")
    except UnicodeDecodeError:
        print("UTF-8严格解码失败")
    assert 文件.read_text(encoding="gbk") == "茶叶,12\n"
    print("显式GBK解码通过")
本稿的隔离验证实际使用 Python 3.14.3,并通过 -X utf8=1 与 -X utf8=0 切换模式;没有在 Python 3.15 或真实业务数据上运行。实验另验证了默认读取、编码警告、BOM 与新文件转码,共 19 项检查通过。这是行为夹具,不冒充完整升级验收。
四、修复入口:按文件约定明确编码
若生产方确认交付 GBK,就使用 encoding="gbk";若协议确认 UTF-8,就使用 encoding="utf-8"。优先在文件读写边界写清约定,而不是为整个进程反复猜编码。纯 ASCII 样本常同时满足多种编码,检测工具给出的猜测也不能替代来源说明。
UTF-8 带 BOM 的输入可按交付约定使用 utf-8-sig,它在读取时处理起始 BOM;普通 utf-8 读取会保留开头的 U+FEFF,可能污染第一列表头。GBK、GB18030 与其他编码不能随便互换,能解码不等于内容正确,应核对中文、特殊字符及字段。
errors="ignore" 会悄悄丢字节,replace 会用替换字符掩盖问题。对账、路径和配置内容通常应保留 strict;故障显露出来,比“任务绿色、内容少字”更容易修。确有容错需求,也要单独记录损失,不能把它算作无损迁移。
五、需要统一格式时,另写新文件再验收
仅在来源已确认为 GBK 时,把下面保存为 convert.py;在授权测试目录执行 python3 convert.py legacy.txt migrated.txt。它先严格解码,再编码成 UTF-8,使用 xb 拒绝覆盖已存在的目标,源文件始终不改写。
from pathlib import Path
import sys
源, 目标 = map(Path, sys.argv[1:3])
文本 = 源.read_bytes().decode("gbk", errors="strict")
新字节 = 文本.encode("utf-8", errors="strict")
with 目标.open("xb") as 输出:
    输出.write(新字节)
assert 目标.read_bytes().decode("utf-8") == 文本
print("新文件文本一致;源文件未改写")
这份短示例会把完整文件装入内存,适合小文件。大文件需采用增量解码与限量处理,不能逐块独立 decode 切断多字节字符。写入途中失败可能留下不完整新文件;本示例不保证原子发布、断电持久化或并发安全,不能直接拿它替换生产文件。
断言只核对文本一致,业务仍须验证记录数、字段与下游导入。换行、BOM 和输出编码按接收方协议确认,原件保留到验收结束。
六、提前找隐式编码,临时退回要有限期
Python 3.10+ 可在隔离环境运行 python3 -X warn_default_encoding your_script.py(替换为待查脚本);执行隐式编码入口会发出 EncodingWarning,没有警告不等于覆盖整个项目。本文另验证了缺 encoding 警告及显式指定后无警告。
UTF-8 开关从 Python 3.7 提供,在 Python 3.11+ 可用 python3 -X utf8=1 probe.py 预演。3.15 仍允许 -X utf8=0 或启动前 PYTHONUTF8=0 临时关闭;只恢复 locale 默认选择,不强制 GBK,也不修复数据。UTF-8 locale 下关闭仍可能用 UTF-8。
临时开关应设移除节点。跟随 locale 是环境策略,不等于确认旧文件格式。
七、按症状分流,别把所有乱码当同一类
| 现象 | 优先检查 | 下一步 |
|---|---|---|
| 读取报 UnicodeDecodeError | 文件来源、实际字节、encoding | 保留原件,按约定严格解码 |
| 不报错却出现乱码 | 错误编码是否刚好可解码 | 逐字段比对已知正确样本 |
| 第一列表头多一个字符 | 起始 BOM 与输入协议 | 明确是否采用 utf-8-sig |
| 文件读对,终端仍异常 | stdout 编码与接收端 | 分开验收文件与输出链路 |
| 转换目标已存在 | 是否为旧结果或失败残留 | 确认归属,另选新路径,不盲覆盖 |
八、升级通过,至少要拿到这些证据
- 实际服务解释器版本与 UTF-8 模式已采样,所有文本边界都有编码约定。
- 真实样本覆盖中文、特殊字符、BOM 与空文件,严格解码和文本核对均通过。
- 新文件记录数与业务字段一致,下游按约定成功接收;原文件保留。
- 异常分支会失败并可追踪,不通过 ignore、全局降级或吞异常伪造成功。
参考资料:Python 3.15.0 官方发布公告;PEP 686;io 文本编码文档;命令行选项;locale API。
🔕 评论已关闭