Python脚本第一次统计有数据,第二次保存却一条也没写;加了调试日志之后,问题反而出现了。先检查传下去的是列表,还是已经被消费的生成器。下面在Python 3.14.3中用内存隔离实验复现,分清一次性迭代、短路消费和快照复用,不把“没有报错”当成数据完整。
一、不是数据消失,是游标已经走完
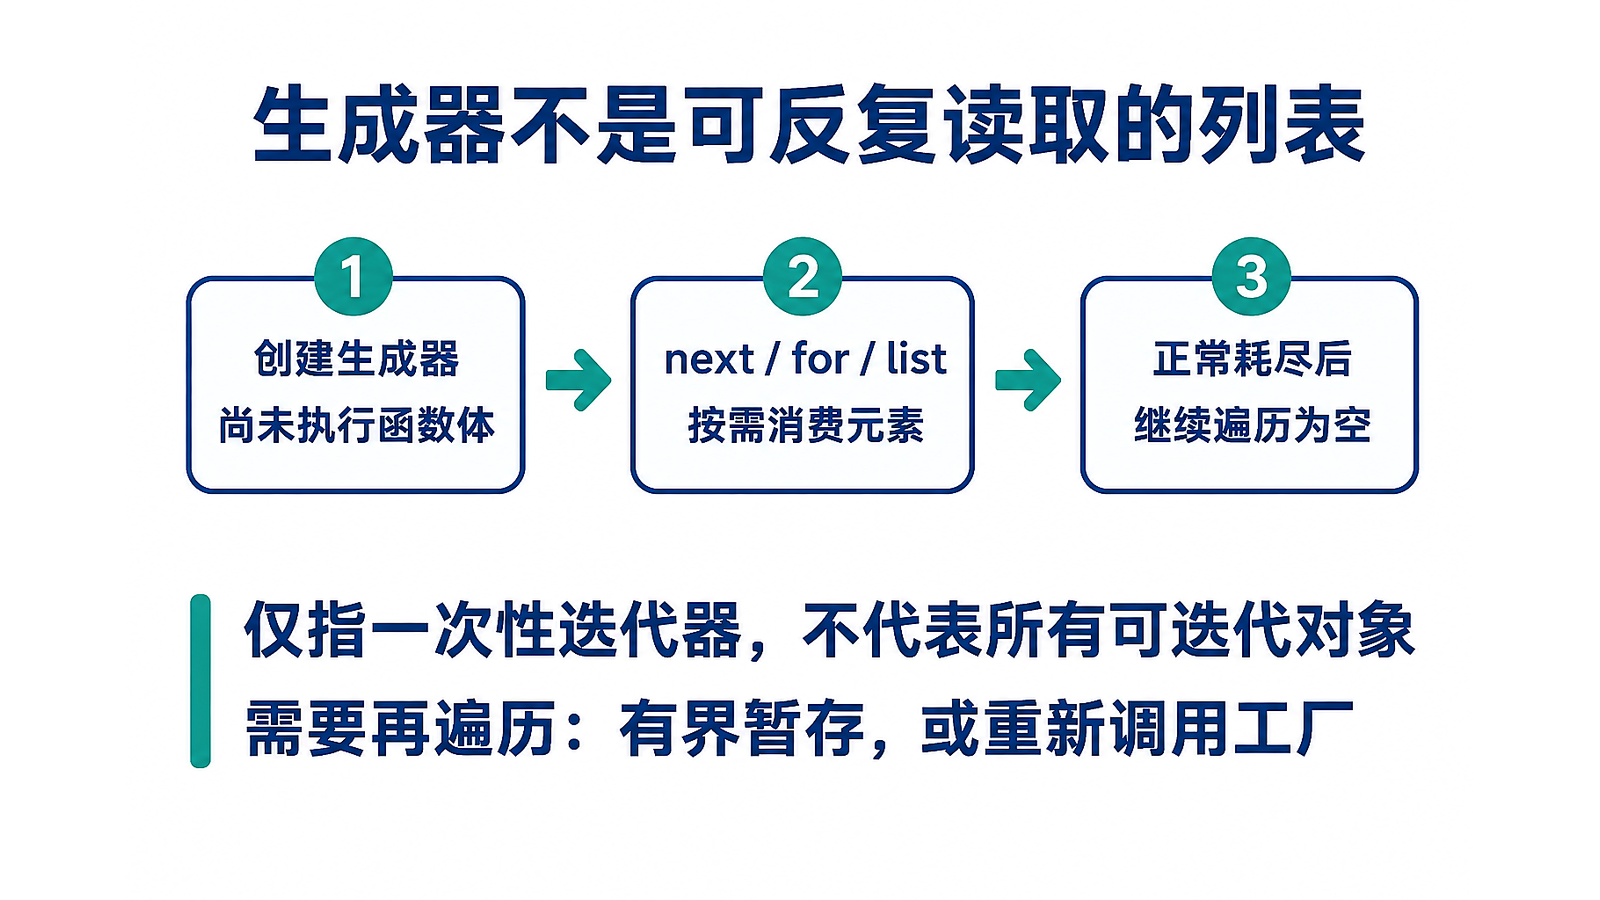
包含yield的函数是生成器函数,调用它会返回生成器迭代器,函数体此时还没开始执行。next、for或者list向它取值时,函数体才推进到下一个yield。到达正常结束位置后,这一份迭代器就耗尽了。
列表属于可以反复取得新迭代器的可迭代对象;生成器本身就是一次性迭代器。两者都能写进for循环,接口看起来相同,重复遍历的能力却不同。官方迭代器协议要求:一旦以StopIteration表示耗尽,后续调用也应继续表示耗尽。
所以list(数据)不是“查看一下”,而是把剩余元素全部取出来组成新列表。第一次调用留下的列表可以复用,原来的生成器不会因此回到开头。不要把能遍历和能重放当成一个条件。
二、日志和检查也可能先吃掉数据
常见问题是先用list打印输入,再把原对象交给保存函数。日志记录得很完整,真正的消费者拿到的却是空流。需要调试时,应明确保留快照并把这份快照传下去,而不是继续传已经耗尽的原对象。
并非只有完整遍历才影响状态。next会取走一个元素;any会不断取值,遇到第一个真值就停止,all则遇到第一个假值停止。短路意味着不一定耗尽,也绝不意味着已经取出的元素自动退回。
例如元素是0、1、2,any先取到假值0,再取到真值1,剩下只有2。随后遍历不是空,却依然丢了前两项。布尔检查正确,与后面的数据集合完整,是两回事。
三、复制即可运行的五组对照
把代码保存为随文实验.py,用python3 随文实验.py执行;不要加会关闭断言的-O。程序只处理合成的内存数据,没有文件、数据库或真实接口请求。五条“通过”表示对应断言满足,不代表线上数据已经补齐。
from itertools import tee


def 读取数据():
    for 值 in (0, 1, 2):
        yield 值


数据 = 读取数据()
assert iter(数据) is 数据
assert list(数据) == [0, 1, 2]
assert list(数据) == []
print('通过:一次性迭代器正常耗尽后不重放')

数据 = 读取数据()
assert any(数据) is True
assert list(数据) == [2]
print('通过:any在真值处停止,已取出的元素不退回')

数据 = 读取数据()
assert next(数据) == 0
assert list(数据) == [1, 2]
print('通过:预览next也会消费')

快照 = list(读取数据())
assert list(快照) == [0, 1, 2]
assert list(快照) == [0, 1, 2]
assert list(读取数据()) == list(读取数据()) == 快照
print('通过:有界快照可重遍历,工厂可创建新迭代器')

原流 = iter([{'计数': 0}])
左, 右 = tee(原流)
左项 = next(左)
左项['计数'] = 9
assert next(右) is 左项
assert 左项['计数'] == 9
print('通过:tee分支共享元素对象,不是深复制')
最后一组故意修改同一个字典,说明tee没有深复制元素。这里不依赖小整数的对象身份,也没有把线程调度或者外部输入稳定性混进测试。
四、数据有上限,保存一次快照
如果数据量确定能装进内存,最直接的方案是只做一次list转换,后续统计、打印和保存都使用这份列表。这既避免重复消费,也让各步骤面对同一批已取出的元素;代价是全部元素及列表引用需要占用内存。
“最多几十条配置”与“不知道多大的导出”不能套用同一策略。对无限迭代器调用list不会正常完成;对巨大输入则可能耗尽内存。应先确定记录数量、单条体积和总预算,而不是为了修空结果把所有流都强行列表化。
列表快照只保存元素引用。元素是字典时,后续原地修改仍会影响看到这些对象的其他代码。若需要内容隔离,必须按业务对象设计复制策略;这不是把生成器转成列表就顺带解决的问题。
五、数据不能暂存,就传工厂而非旧迭代器
另一种方案是让每轮调用一个工厂函数,由它重新创建迭代器。随文实验的读取数据就是这种情况:每次都返回全新生成器,处理固定内存序列,所以结果相同。这不是让旧生成器“复活”。
工厂若重新查询数据库、打开文件或发起网络请求,第二轮可能拿到不同版本,也可能重复计费或触发副作用。先决定业务是否允许重新读取,必要时使用数据版本、事务快照或上游分页标记,不能以两轮元素数量相同推断内容一致。
有资源的生成器还要管理关闭时机。提前break不等于所有自定义迭代器都完成资源清理,本文的纯内存示例没有验证文件句柄、连接或事务的生命周期,实际接入时应另设上下文和清理验收。
六、tee不是免费的双份数据
itertools.tee能从同一个可迭代输入生成多个独立推进的分支;“独立”说的是读取位置,不是元素对象。慢分支尚未读取、快分支已经越过的元素需要被保留,因此两个分支进度差很大时,缓存也可能很大。
官方文档还提醒:分支产生后不要再直接消费原迭代器;tee迭代器不是线程安全的。它不适合被当成无界流的免费广播器,也不能凭分支各自可next就声称支持线程并发。
如果某个分支将先完整读取全部输入,再由另一个分支开始读取,直接保存列表通常更直观。是否使用tee,应由输入上限、分支推进节奏与内存预算决定,而不是看函数名像“复制”。
七、按现象选择修复,不盲目重跑
| 现象 | 检查点 | 处理方向 |
|---|---|---|
| 第二次遍历为空 | 第一次是否完整消费同一迭代器 | 复用有界快照,或明确重建 |
| 只缺前面几条 | next、any、all和预览代码 | 移除隐式消费,追踪取值位置 |
| tee后内存持续增长 | 快慢分支差距与输入规模 | 限制积压或换有界处理方案 |
| 重建后数据变了 | 上游版本和重复读取副作用 | 明确一致性约定,不自动补写 |
排查日志只记录类型、阶段、计数和安全的版本标记,不要为查空数据把整份用户记录打印出来。消费动作集中到边界处理,往往比在每层都加一个list更容易审计。
八、验收要核对元素,不只核对退出码
- 明确参数接收可重复容器、一次性迭代器,还是创建输入的工厂。
- 成功、预览、短路、正常耗尽四种路径分别检查剩余元素。
- 快照核对内存上限;tee核对分支积压和共享可变元素。
- 重新读取核对数据版本与副作用,不把重放当成回滚。
- 实际保存还需核对条数、标识和内容;内存实验不替代业务验收。
参考资料:Python官方:迭代器协议、Python官方:tee的缓存与线程边界、Python官方:迭代器与生成器。这些都是长期存在的机制,不包装成近期新增功能。
🔕 评论已关闭