普通字典已经存好结果,构造函数却在每次读取时继续执行?先检查是否写了d.setdefault(k, build()),或给get也传入构造调用。它们会先计算实参。用显式成员分支即可避开命中时的多余调用;以下纯内存实验限于单线程顺序访问,工厂不修改原字典。
一、缓存命中,不等于构造函数没运行
看见键已存在、返回值也是旧对象,很容易认为构造工作已经跳过。但返回了什么,与返回之前执行了什么,是两件事。默认结果没被使用,不代表生成它的表达式没执行。
无需真的访问网络或打开文件。让构造函数向计数列表追加一次,就能观察额外工作。实际函数若耗时较长,浪费的是时间;若会抛异常,甚至让本应返回缓存的读取失败。先数调用次数,比只比较返回值更能说明问题。
二、原因在调用前,不在字典内部
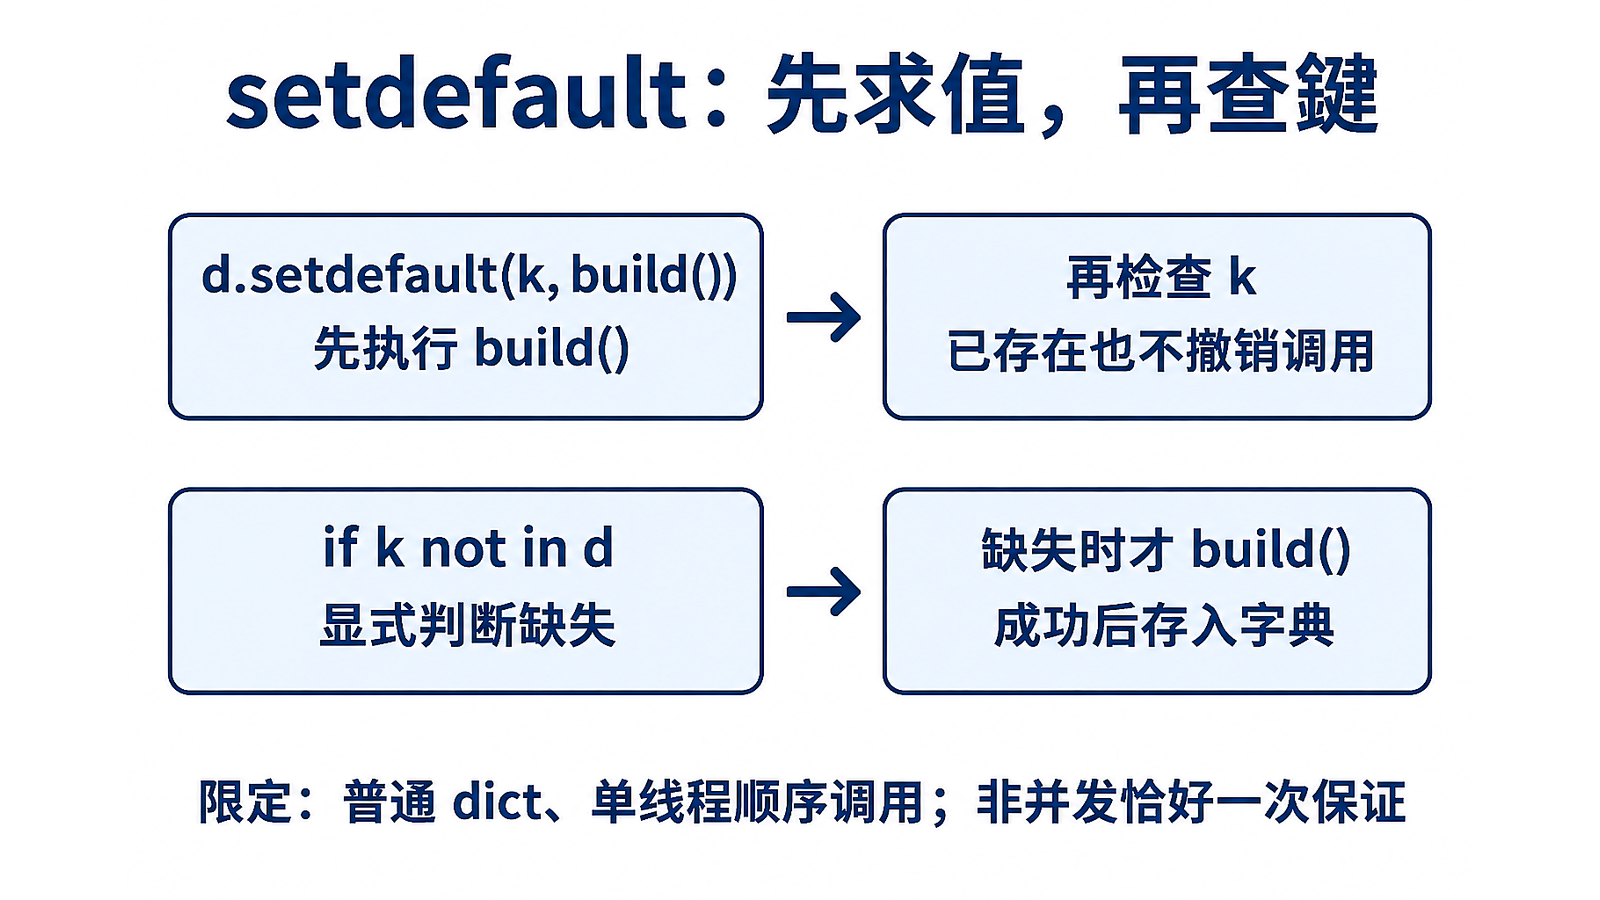
Python调用表达式的规则是:尝试调用之前,先求出所有实参表达式的值。因此build()先运行,得到的结果才作为默认值传给字典方法。随后setdefault检查键:存在就返回原值,不存在才插入已经算好的默认值。它不会撤销前面那次构造。
get同样接收已求值的默认值,却不会因为缺键而写回字典。因此缺键时反复使用它,也不会积累缓存。这不是函数定义时的可变默认参数问题,也不是装饰器缓存的线程协调问题。实验使用Python 3.14.3,但这不是该版本新增的机制,也不需要新语法。
三、显式判断缺键,别判断值是否为真
直接的修复是先写if k not in d:,在分支内执行d[k] = build(),最后读取d[k]。关键是把构造放进受条件控制的语句块。
不要改成d.get(k) or build()。短路运算判断的是值的真假,不是成员资格。已经保存的None、False、零、空字符串和空容器,都会让右侧继续运行,而且这个表达式本身依然不负责写回。若“空结果”也是合法缓存,这会把正常命中当成缺失。使用成员判断,还能区分“保存了空值”和“根本没有这个键”。
四、选择方法时,把读取和填充分开看
| 写法 | 命中时构造 | 缺键后写入 |
|---|---|---|
| setdefault(k, build()) | 会 | 会,构造成功后 |
| get(k, build()) | 会 | 不会 |
| 显式成员分支 | 不会 | 会,构造成功后 |
| defaultdict(build)[k] | 不会 | 会,工厂成功后 |
所有缺键都采用同一种无参构造时,可以选择defaultdict(build)。传入的是可调用工厂,不是执行结果。它在下标读取缺键时调用工厂,再保存返回值。接口不会把键传给工厂;如果构造需要当前键,显式分支更直观。
还要注意读取入口:get不会触发缺键工厂,成员检查也不会。把下标读取换成它,可能改变填充行为。反过来,将只想探测的读取换成下标,也可能创建原本不存在的条目。先确认调用者是否允许读取产生写入。
五、构造失败时,异常不会凭空消失
即使键已存在,提前求值的构造函数也可能先抛异常,字典方法还来不及返回旧值。这解释了为什么“明明有缓存”仍可能报构造错误。显式分支能避开命中时的这条路径,但缺键时该发生的异常仍会向上传播,不应为了掩盖它而随便返回空对象。
在本文约定下,赋值右侧构造失败,赋值不会完成,缺失键仍未写入。对于defaultdict,工厂异常会原样传播,这次失败也不会插入默认条目。后续再次用下标读取,仍有机会再次调用工厂;如果故障持续,也会继续失败。缓存容器不会自动记住一次异常,更没有替业务决定重试次数、退避或错误缓存策略。
六、六组纯内存实验,可完整复制运行
计数列表只记录调用,不修改被查询的字典。断言检查对象身份、字典内容和异常。第六组主动抛出真实的值错误,让同一个工厂先失败、再成功,不使用网络、文件或模拟接口响应。保存为Python文件运行,不要带优化选项,以免关闭断言。
from collections import defaultdict

calls = []

def build(fail=False):
    calls.append(1)
    if fail:
        raise ValueError("fail")
    return []

def cached(d, k, factory=build):
    if k not in d:
        d[k] = factory()
    return d[k]

def fails(action):
    try:
        action()
    except ValueError:
        pass
    else:
        raise AssertionError("ValueError")

# 1
calls.clear()
for method in ("setdefault", "get"):
    old = []
    d = {"k": old}
    assert getattr(d, method)("k", build()) is old
assert len(calls) == 2
print(1, len(calls))

# 2
d = {}
v = d.get("k", build())
assert d == {} and v == []
assert d.setdefault("k", v) is v and d["k"] is v
print(2, "no/yes")

# 3
calls.clear()
for v in (None, False, 0, "", [], {}, set(), ()):
    d = {"k": v}
    assert cached(d, "k") is v
    d.get("k") or build()
assert len(calls) == 8
print(3, len(calls))

# 4
calls.clear()
d = {}
v = cached(d, "k")
assert cached(d, "k") is v and len(calls) == 1
print(4, len(calls))

# 5
calls.clear()
d = defaultdict(build)
assert d.get("k") is None and not d and not calls
v = d["k"]
assert d["k"] is v and len(calls) == 1
print(5, len(calls))

# 6
for method in ("setdefault", "get"):
    d = {"k": 0}
    fails(lambda: getattr(d, method)("k", build(True)))
    assert d == {"k": 0}
assert cached(d, "k", lambda: build(True)) == 0
d = {}
fails(lambda: cached(d, "k", lambda: build(True)))
assert not d
calls.clear()
d = defaultdict(lambda: build(not calls))
fails(lambda: d["k"])
assert not d and len(calls) == 1
assert d["k"] == [] and len(calls) == 2
print(6, len(calls))
六组断言均通过:命中仍构造;八种假值命中不触发显式分支,却触发短路写法;两次分支读取只构造一次;工厂失败未插入,下次成功。输出首列为组号,第二组为两种方法是否插入,第三组次数属于错误写法,第五组属于下标读取。固定样本不是性能基准。
七、这段分支不承诺并发恰好一次
全文以普通字典、单线程顺序访问为前提,并约定构造函数不修改正在查询的字典,也不通过回调重入填充流程。检查、构造和写入是分开的步骤,不是一项原子事务。多个线程或其他并发执行者都可能看到缺键,然后各自开始构造。需要协调时,应单独设计同步和失败处理,而不是把这一分支当作锁。
即使没有多线程,也不能从这个语法推导出构造函数永远不会重入或改动原字典。那是函数本身及其调用链的约束,需要另行审查。这里的实验工厂遵守该约束,故意不把复杂副作用混进基础案例。顺序重复读取可复用成功结果,不等于容器自动解决了生命周期、过期、容量或业务幂等问题。
八、验收先看行为,再决定是否替换
- 命中现有键时,构造计数不增长,返回的仍是原对象;空值也必须覆盖到。
- 缺键时,确认需要的是只读默认返回,还是成功构造后写回,不混用两种语义。
- 让构造真实失败一次,检查异常仍可观察、失败结果未存入,再验证后续尝试。
- 使用工厂时,分别测试下标和get入口;另外审查并发、重入及工厂副作用。
替换前,确认空值是否有效、异常由哪层处理。不需要缺键填充,就保留单纯读取,不为缩短代码引入隐含写入。
🔕 评论已关闭