一、先确认漏的是哪一类元素
从列表里剔除偶数,循环没报错,结果却还剩一个偶数。这类问题容易被误认为条件写反了。先把输入缩成连续命中的几个数,再记录实际残留,比盯着一大段业务循环更容易定位。本文用合成数字复现,不连接外部服务,也不执行真实业务删除。
讨论范围限定为普通内置list,按原顺序访问。正常过滤的谓词只做判断,不修改输入或元素,没有并发写入,也没有自定义相等比较的额外行为。字典、集合和自定义容器不能直接套用这里的结论。示例在Python 3.14.3隔离子进程中运行,官方资料采用3.14文档。
二、删除会移位,迭代索引却继续前进
对[2, 4, 6, 7]一边遍历一边调用remove,第一次读到2后将它删除,4就从索引一移到了索引零。下一次迭代继续读索引一,拿到的是6。删除6之后,索引继续推进,循环结束,最终残留[4, 7]。4没有被判定过,问题出在访问过程,不在偶数条件。
内置类型文档说明,可变序列的正向迭代器通过索引取值,即使序列被修改,索引仍继续向前推进。这里不会因为漏处理自动抛异常。官方教程因此建议遍历集合副本,或构造新集合。只拿交错的奇偶数测试可能碰巧通过,连续命中才更容易把这个漏洞暴露出来。
三、不需要旧对象时,直接创建过滤结果
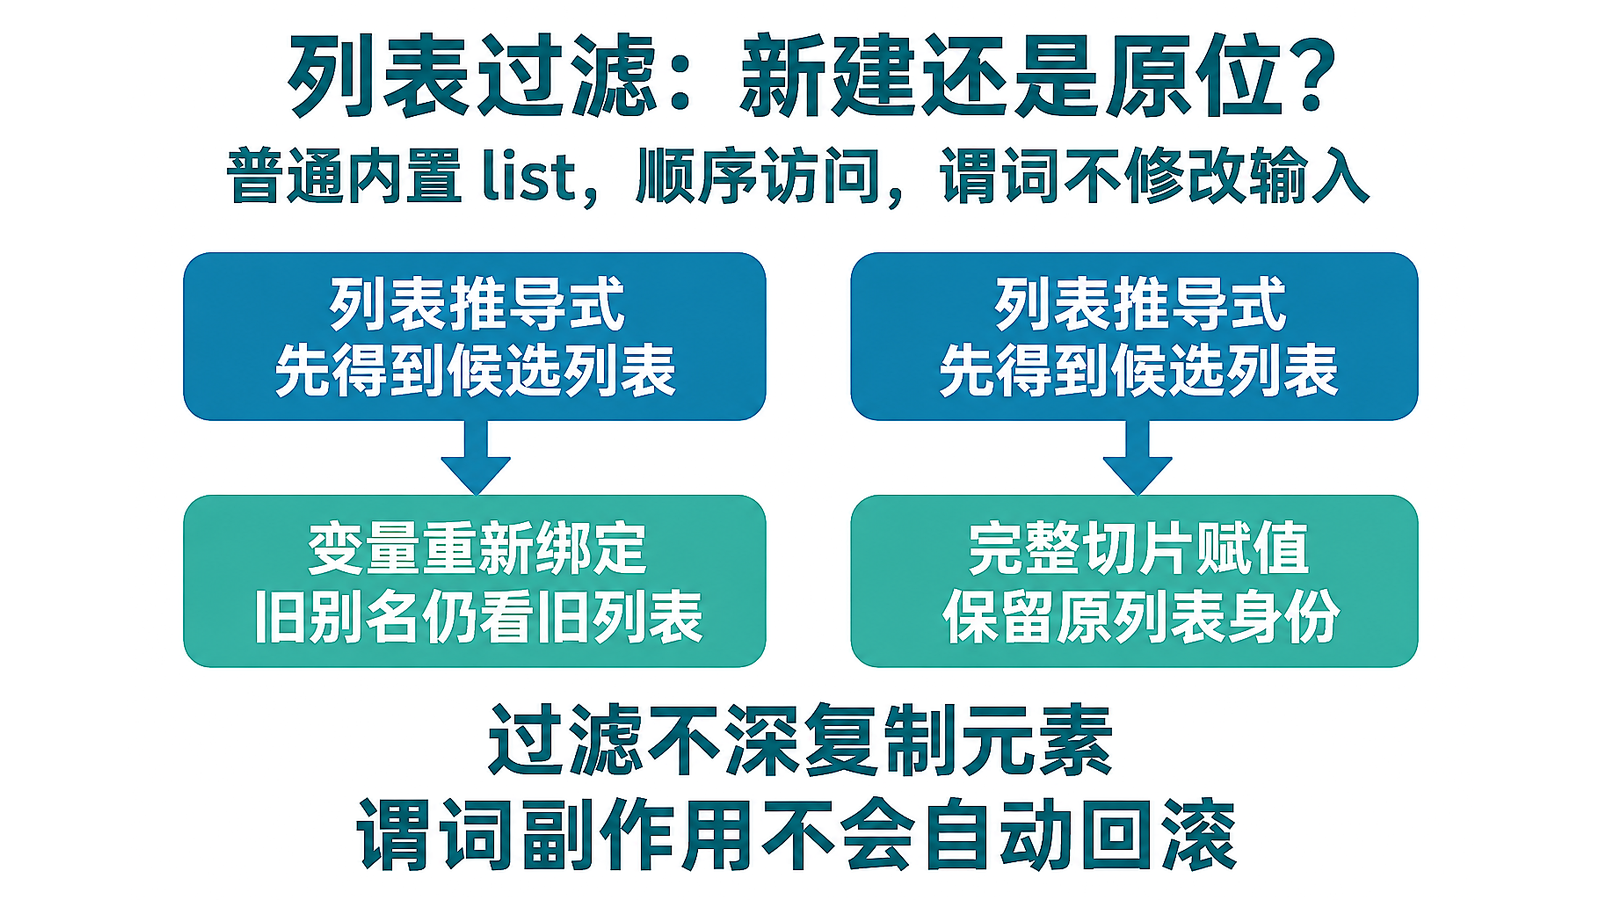
列表推导式表达的是保留条件。删除偶数就保留奇数,不必先找位置再逐个删除。它按输入顺序收集命中的元素,不会去重;两个相同的奇数都应该留下。空列表得到空结果,全部保留也会创建一个新的外层列表,这些边界都值得单独核验。
把新结果赋给原变量,只改变这个名字指向的对象。若另一个变量此前引用旧列表,它仍然看到旧内容。方法内部重新绑定形参,同样不会替调用方改掉已有引用。先明确调用方需要新结果还是共享列表内容更新,再选写法,不要因为变量名没变就以为对象没换。
新建方案适合把输入当作只读材料的函数:返回筛选结果,由调用方决定是否替换自己的变量。测试不能只看返回值,还要回头检查输入没有被改写。这样能防止后续维护时把函数悄悄换成原位删除,却仍让原来的结果比较继续通过。
四、要保留列表身份,用完整切片赋值
共享引用需要看到更新时,可以使用列表[:] = [数 for 数 in 列表 if 保留条件]。左侧的完整切片替换原列表全部内容,列表对象自身保留。原先的别名仍指向它,因此也能看到过滤后的内容,长度可以随结果改变。
赋值会先完成右侧表达式,再处理左侧目标。本例右侧是列表推导式,所以会先得到完整候选列表,再替换原列表内容。它不是边判断边往原列表塞结果,代价是需要容纳候选列表的额外空间。这个求值顺序只解释本例的提交时点,不能据此宣称并发安全或具有事务能力。
身份保留不等于内容保留。过滤完成后,原列表里的偶数引用已经被移出,持有别名的代码会读到更短的列表。若调用方本来就需要继续读取旧快照,原位更新反而违背约定,应返回新列表。两种写法都能筛掉偶数,但它们对其他引用的影响不同。
五、完整示例与隔离复现
下面代码可独立保存执行,不需要第三方依赖。先保留错误写法作为负例,再验证新建与原位两种修复。验收采用显式条件与异常,不依赖assert。每次核验通过才输出一行;缺少预期异常会直接失败,避免把异常分支根本没有运行误当成成功。
本次执行得到十九项通过,错误写法实际残留[4, 7]。五组输入分别检验两种方案,其余项目检查别名、首个匹配、共享元素和失败路径。最后的访问记录只用于观察顺序,会写入独立日志列表,不修改输入;它不是正常过滤谓词应携带业务副作用的建议。
def 新列表(列表):
    return [数 for 数 in 列表 if 数 % 2 != 0]


def 原位过滤(列表):
    列表[:] = 新列表(列表)


通过数 = 0


def 核验(名称, 条件):
    global 通过数
    if not 条件:
        raise RuntimeError("失败:" + 名称)
    通过数 += 1
    print("通过:" + 名称)


if __name__ == "__main__":
    列表 = [2, 4, 6, 7]
    for 数 in 列表:
        if 数 % 2 == 0:
            列表.remove(数)
    print("错误写法残留:", 列表)
    核验("移位漏处理", 列表 == [4, 7])

    for 名称, 输入, 预期 in [
        ("连续命中", [2, 4, 6, 7], [7]),
        ("全部删除", [2, 4], []),
        ("全部保留", [1, 3], [1, 3]),
        ("空列表", [], []),
        ("重复值", [2, 2, 1, 1, 4], [1, 1]),
    ]:
        列表 = 输入.copy()
        别名 = 列表
        结果 = 新列表(列表)
        核验(名称 + "新建", 结果 == 预期 and 结果 is not 别名 and 别名 == 输入)
        原位过滤(列表)
        核验(名称 + "原位", 列表 == 预期 and 列表 is 别名)

    列表 = [1, 2, 3]
    别名 = 列表
    列表 = 新列表(列表)
    核验("重新绑定不改别名", 列表 == [1, 3] and 别名 == [1, 2, 3] and 列表 is not 别名)
    列表 = [2, 2, 3]
    列表.remove(2)
    核验("只删首个匹配", 列表 == [2, 3])
    列表 = [2, 2, 3]
    for 数 in 列表.copy():
        if 数 % 2 == 0:
            列表.remove(数)
    核验("副本遍历对照", 列表 == [3])

    元素 = {"数": 1}
    列表 = [元素]
    结果 = [项 for 项 in 列表 if 项["数"] % 2 != 0]
    结果[0]["数"] = 9
    核验("浅过滤共享元素", 结果 is not 列表 and 结果[0] is 元素 and 列表[0]["数"] == 9)

    def 会失败(数):
        if 数 == 4:
            raise ValueError("模拟判定失败")
        return 数 % 2 != 0

    for 方式 in ("新建", "切片"):
        列表 = [1, 2, 4]
        别名 = 列表
        try:
            if 方式 == "切片":
                列表[:] = [数 for 数 in 列表 if 会失败(数)]
            else:
                列表 = [数 for 数 in 列表 if 会失败(数)]
        except ValueError:
            核验(方式 + "纯谓词失败", 列表 is 别名 and 列表 == [1, 2, 4])
        else:
            raise RuntimeError("未触发预期异常")

    列表 = [1, 2, 4]

    def 有副作用(数):
        列表[0] = 99
        raise ValueError("修改输入后失败")

    try:
        列表[:] = [数 for 数 in 列表 if 有副作用(数)]
    except ValueError:
        核验("副作用不会回滚", 列表 == [99, 2, 4])
    else:
        raise RuntimeError("未触发预期异常")

    访问 = []
    结果 = [数 for 数 in [3, 2, 1, 1] if not 访问.append(数) and 数 % 2 != 0]
    核验("顺序访问对照", 访问 == [3, 2, 1, 1] and 结果 == [3, 1, 1])
    print("全部通过:", 通过数)
六、失败之前的副作用不会自动撤销
纯谓词在遇到4时抛出ValueError,右侧推导式未能完成,完整切片赋值尚未发生,原列表与别名保持原样。新建后重新绑定的分支也一样,右侧失败就不会完成绑定。已创建的局部候选结果不应被当成成功输出,调用方应让异常传播,或明确报告过滤失败。
反例故意让谓词先把输入首项改成99,再抛异常。此时赋值虽然没有发生,输入仍留下99。切片写法不会替谓词撤销修改,文件写入、网络请求等外部副作用也不在其保护范围内。另一个独立边界是浅过滤:保留下来的字典仍是同一个字典,修改其字段,旧列表引用也能看到。
若数据来自记录列表,先决定字段缺失时应拒绝整批还是跳过该条,再编写保留条件。不要为了让循环结束而捕获所有异常并返回空列表,那会把判断失败伪装成全部删除。过滤与错误处理的约定应分别写清,测试也应分别验证。
七、按症状选择修复,不靠反复补删
remove按相等比较移除首个匹配项,不是按当前迭代位置删除,也不是一次删除全部重复值。副本遍历再remove能绕开原列表移位影响遍历的问题,但反复搜索与移动元素可能带来平方级代价;这里没有做性能基准,不给固定耗时或提速承诺。
如果目标只是筛选保留项,过滤通常更贴近意图。不要用再跑一遍循环掩盖漏处理,也不要为删偶数先排序,排序会改变原有顺序且没有解决访问方式本身的问题。检查时把内容正确与身份正确分开:相等比较检查结果,is检查对象是否仍为原来的那个。
| 故障现象 | 判断依据 | 修复方向 |
|---|---|---|
| 偶数仍残留 | 删除后索引推进 | 过滤保留项 |
| 别名还是旧内容 | 变量绑定新对象 | 完整切片赋值 |
| 字典字段一起变 | 保留元素仍共享 | 另定复制策略 |
| 报错后输入已变 | 谓词先修改输入 | 拆出副作用 |
八、把验收条件留给后续维护
接入真实调用链前,应先确认别名由谁持有,保留条件是否只读,以及元素内部是否允许共享。本文结果只覆盖合成输入和指定解释器,不代表业务数据清理已经完成。若调用方仍在遍历同一列表,先协调访问时点,不要在遍历尚未结束时原位替换。需要历史快照时返回新列表,不能只凭对象身份保持就认定所有调用方都兼容。下列检查项用于回归;参考链接分别支撑修改集合的建议、序列操作语义与赋值求值顺序。
- 连续命中、全删、全留、空表与重复值结果正确。
- 保留顺序与重复项;新建和原位身份契约分别成立。
- 纯谓词失败不提交结果,副作用反例确实留下修改。
- 已识别可变元素共享,不把浅过滤当深复制。
- 从最终HTML抽取代码,与源文件一致且执行通过。
🔕 评论已关闭