一、接口前缀没有报错,却少了一层
假设你在写 Python 接口脚本,把 https://example.org/api/v1 交给 urljoin,再拼上 users,预期走 /api/v1/users,得到的却是 /api/users。字符串没有异常,版本前缀却丢了。本文用离线对照定位尾斜杠与右侧引用类型,再给出一个只接收受控相对路径的教学构造器。
先不要改代理配置,也不用猜服务端重定向。这个现象在发出请求之前就能复现:把两个入参和返回值打印出来即可。本文的完整实验只调用标准库处理字符串,不建立连接。它能说明地址如何形成,不能说明某个接口可访问,更不能证明鉴权或业务处理成功。
排查时最好用 repr 保存原始入参,连同调用处一起看。配置入口、业务传参和解析返回值最好分开记录,别拿最终地址倒推原始输入。最小复现先固定字面量,确认规则后再检查真实调用链,才能分清是配置写错,还是上游改变了引用类型。肉眼看起来差不多的两条基准地址,可能只差末尾一个斜杠;右侧值也可能从 users 悄悄变成 /users。不要先把输入“清理干净”再调查,否则最有价值的差异会被自己擦掉。
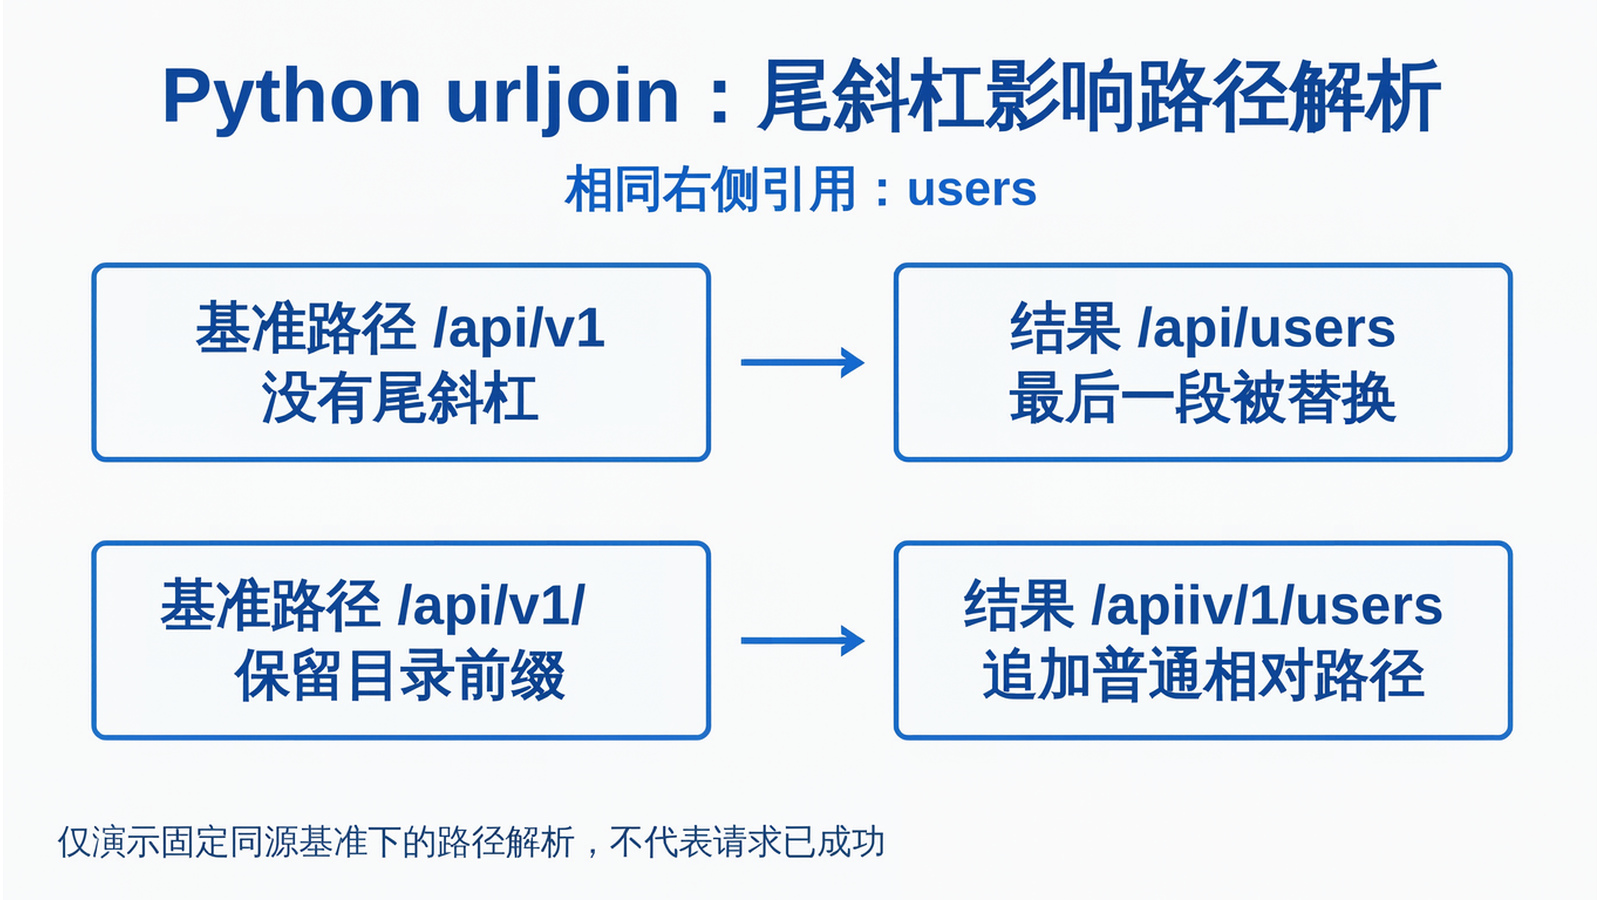
二、尾斜杠决定最后一段是否参与替换
urljoin 做的是 URL 引用解析,不是字符串目录拼接。对普通相对路径 users,基准路径 /api/v1 会先去掉最后一个斜杠之后的 v1,再合并 users,所以结果是 /api/users。基准改成 /api/v1/ 后,最后那个斜杠之后为空,已有目录前缀便能保留下来。
这正对应 RFC 3986 第 5.2.3 节的路径合并规则。可以把没有尾斜杠的最后一段理解成“待替换的位置”,但不要反过来说它一定是文件:解析器既不查询磁盘,也不判断这个接口代表文件还是目录。它只根据 URL 的组成和字符位置计算。
因此,给目录式基准明确补上尾斜杠,是修复这一类配置错误的办法,却不是所有拼接问题的万能补丁。下一步仍要检查右侧值。即使基准已经写成 /api/v1/,右侧若自带根路径或主机信息,也不会按你想象的方式追加在后面。
三、先分清右侧是哪一种引用
右侧 users 属于相对路径,才需要与基准目录合并;/users 是根路径引用,直接从站点根部计算,原来的 /api/v1/ 被替换。两者的区别不是样式问题,而是不同的解析分支。接口文档如果给的是站点根路径,就不能为了保留自己的前缀而随手删掉斜杠。
//other.example/users 则包含 authority,会继承这里的 https 协议,同时换掉主机部分;https://other.example/users 自带完整协议和主机,可以改变来源。这里的 authority 是包含主机及可能端口等信息的组成部分,不只是路径的另一种写法。信任基准地址,不代表右侧地址自动可信。
| 输入特征 | 典型结果 | 定位与处理 |
|---|---|---|
| /api/v1 加 users | /api/users | 最后一段被替换,检查目录式基准尾斜杠 |
| /api/v1/ 加 users | /api/v1/users | 普通相对路径,保留目录前缀 |
| 右侧 /users | 同主机的 /users | 根路径替换,不是尾斜杠失效 |
| 右侧 //other.example/users | https://other.example/users | 继承 scheme,替换 authority |
| 右侧 https://other.example/users | 采用右侧绝对地址 | 确认业务是否允许换来源 |
四、点段、查询和片段不走同一条路
./users 表示当前层,../users 会向上一层解析;点段处理发生在路径层面,而不是对整条字符串做替换。RFC 3986 第 5.2.2 节先区分 scheme、authority、path、query 和 fragment,再决定继承或替换哪些部分。把它记成“总是在两个字符串中间补斜杠”,迟早会遇到反例。
仅查询引用 ?y 保留基准路径并替换查询;仅片段引用 #s 在下面的例子中保留路径和已有查询,再设置片段。实验采用第 5.4 节的原始基准 http://a/b/c/d;p?q,对照结果不靠自己猜。空引用在这个不带片段的基准上返回原值,不意味着空字符串在所有业务里都应该被接受。
这里刻意不把 urljoin 说成完整 RFC 验证器。Python 文档也提醒,这组 API 有历史兼容行为,不能宣称全面符合某一个 URL 标准。文档中的 Python 3.5 记录是“行为更新以匹配 RFC 3986 语义”,不是说 urljoin 到 3.5 才首次出现,更不是某次新版本刚修好了本文的问题。
五、先定义业务要收什么,再写构造器
如果业务明确只允许固定接口目录下的资源名,最容易讲清楚的约定是:基准固定为可信的 https://example.org/api/v1/,入参必须是非空 str,每一段只由 ASCII 字母、数字、下划线、连字符组成,段与段之间只用一个斜杠。用 fullmatch 检查整个输入,不做静默纠正。
这个约定会拒绝空段、点段、百分号、反斜杠、查询、片段以及 scheme 和 authority。不要对所有输入调用 lstrip('/'):它会把本该暴露的根路径错误藏起来,也不能解决绝对 URL。类型也要先检查,避免把 None、bytes 或其他值自动转换为看似合法的资源名。
这只是本地业务白名单,不是通用 URL 验证器,也不是 SSRF 防护。中文路径、百分号编码等在其他语境中可能完全合法,本例为了缩小输入范围而主动拒绝。若业务需要这些能力,应重新设计路径段与编码的契约,而不是把正则随意放宽后仍沿用原来的安全结论。
六、完整离线实验:每一项都显式检查
下面是一份完整脚本,保存为 sample.py 后用 Python 运行即可。所有预期结果都写在向量中,检查失败会显式抛异常,不依赖可能被优化模式删除的 assert。循环当场执行检查,不会把循环变量留给稍后调用。最后的总数来自实际记录长度,而不是另外手填一个数字。
字节输入单独对照:标准库支持全 ASCII 的 bytes 输入并返回 bytes;本实验的非空 str 与 bytes 混用会抛 TypeError。教学构造器则有意统一只收 str,二者不是同一层限制。负例通过的含义是“按约定拒绝了输入”,不是证明这些输入在所有 URL 场景里都非法。
"""仅做本地字符串解析;不发送请求,不验收HTTP、SSRF防护或业务。"""
import json
import re
import sys
from urllib.parse import urljoin

BASE = "https://example.org/api/v1/"


def 构造地址(相对路径):
    # 固定可信基准,只接收业务约定的ASCII非空路径段。
    if not isinstance(相对路径, str):
        raise TypeError("相对路径必须是str")
    if re.fullmatch(r"[A-Za-z0-9_-]+(?:/[A-Za-z0-9_-]+)*", 相对路径) is None:
        raise ValueError("仅允许ASCII字母、数字、下划线、连字符组成的非空路径段")
    return urljoin(BASE, 相对路径)


def 主程序():
    记录 = []

    def 记结果(名称, 操作, 预期=None, 异常类型=None):
        try:
            实际 = 操作()
        except Exception as 错误:
            if 异常类型 is None or type(错误) is not 异常类型:
                raise RuntimeError(f"{名称}:出现非预期异常") from 错误
            结果 = {"名称": 名称, "通过": True,
                    "异常": type(错误).__name__, "信息": str(错误)}
        else:
            if 异常类型 is not None:
                raise RuntimeError(f"{名称}:未拒绝输入")
            if type(实际) is not type(预期) or 实际 != 预期:
                raise RuntimeError(f"{名称}:实际{实际!r},预期{预期!r}")
            结果 = {"名称": 名称, "通过": True, "实际": repr(实际)}
        记录.append(结果)
        print(json.dumps(结果, ensure_ascii=False))

    # 下列RFC向量直接采用§5.4的基准与预期,不从待测函数生成预期值。
    引用用例 = [
        ("基准无尾斜杠", "https://example.org/api/v1", "users",
         "https://example.org/api/users"),
        ("基准有尾斜杠", BASE, "users", BASE + "users"),
        ("根路径替换", BASE, "/users", "https://example.org/users"),
        ("网络路径换authority", BASE, "//other.example/users",
         "https://other.example/users"),
        ("绝对URL换来源", BASE, "https://other.example/users",
         "https://other.example/users"),
        ("RFC上级路径", "http://a/b/c/d;p?q", "../g", "http://a/b/g"),
        ("RFC当前路径", "http://a/b/c/d;p?q", "./g", "http://a/b/c/g"),
        ("RFC仅查询", "http://a/b/c/d;p?q", "?y", "http://a/b/c/d;p?y"),
        ("RFC仅片段", "http://a/b/c/d;p?q", "#s", "http://a/b/c/d;p?q#s"),
        ("RFC空引用", "http://a/b/c/d;p?q", "", "http://a/b/c/d;p?q"),
    ]
    for 名称, 基准, 引用, 预期 in 引用用例:
        记结果(名称, lambda: urljoin(基准, 引用), 预期)

    记结果("纯ASCII字节", lambda: urljoin(BASE.encode("ascii"), b"users"),
          (BASE + "users").encode("ascii"))
    记结果("非空str与bytes混用拒绝", lambda: urljoin(BASE, b"users"),
          异常类型=TypeError)
    for 相对路径 in ("users", "users_1/order-42"):
        记结果(f"白名单接受{相对路径!r}", lambda: 构造地址(相对路径), BASE + 相对路径)

    拒绝用例 = [
        (None, TypeError), (b"users", TypeError), ("", ValueError),
        ("/users", ValueError), ("//other.example/users", ValueError),
        ("https://other.example/users", ValueError), ("../users", ValueError),
        ("./users", ValueError), ("users//42", ValueError), ("users/", ValueError),
        ("users%2F42", ValueError), (r"users\42", ValueError),
        ("users?q=1", ValueError), ("users#x", ValueError),
        ("用户", ValueError), ("users\n", ValueError),
    ]
    for 相对路径, 异常类型 in 拒绝用例:
        记结果(f"白名单拒绝{相对路径!r}", lambda: 构造地址(相对路径), 异常类型=异常类型)
    print(json.dumps({"解释器": sys.version.split()[0], "检查总数": len(记录),
                      "通过数": sum(项["通过"] for 项 in 记录),
                      "范围": "本地字符串;无网络请求"}, ensure_ascii=False))


if __name__ == "__main__":
    主程序()
七、把解析结果和验收结果分开
本地使用 Python 3.14.3 执行这份代码,并从最终 HTML 抽取唯一代码块再次运行,逐项回执保留在随稿实验文件中。重复运行用于核对交付一致性,不把同一组向量重复算成新场景。对照重点是每个完整返回值与异常类型,不能只看末尾一句“通过”。
即使构造器返回了期望地址,也只证明它满足这份有限输入契约。真实请求仍有 DNS、连接目标、重定向、TLS、HTTP 状态与业务响应等独立检查;本例没有执行这些步骤。尤其不能看到主机字符串没变,就宣称已经完成 SSRF 防护或生产接口验收。
- 核对基准地址的最后一段与尾斜杠是否符合用途。
- 用原始输入区分相对路径、根路径、网络路径和绝对 URL。
- 保留点段、query-only、fragment、空引用的正反对照。
- 确认类型错误和白名单外输入确实抛出预期异常。
- 把字符串解析通过与真实 HTTP、业务验收分别记录。
八、官方资料与排查落点
遇到“拼接后丢了一层”,先看左边有没有尾斜杠,再看右边属于哪种引用。这两个问题通常比继续堆字符串替换更有效。真正需要目录下资源名时,把允许的输入写成清晰契约;需要解析外部引用时,就尊重引用本身的含义,不要用删除字符的办法伪装成另一种输入。
以下资料分别用于核对标准库接口、类型与版本说明,以及路径合并算法和官方例子。阅读时可以直接拿实验中的五个 RFC 向量对照第 5.4 节,再回到第 5.2.2、5.2.3 节解释分支。这样既有能运行的结果,也能说明结果为何成立,而不是只背一个“加斜杠”的口诀。
🔕 评论已关闭