用 SQLite 做账户订单报表时,明明写的是 LEFT JOIN,一加 WHERE o.status = 'paid',零笔已付款订单的账户却从结果里消失了。把右表的状态条件挪进 ON 可以保住这些账户,再用 COUNT(o.id) 把它们记成零。下面用一个内存库复现问题,也看看为什么补一句 OR o.id IS NULL 并不等价。
1. 先定报表的行数,再定计数口径
报表要回答的是「每个启用账户各有多少笔已付款订单」。这句话有两个条件:账户是否启用决定它要不要出现在报表里,订单是否已付款决定它算不算进该账户的数字。零笔不是没数据可展示,而是这个账户在当前统计口径下的结果。导出结果若没有这个账户,后面的程序就分不清它是停用、条件排除,还是应当显示为零。
实验特意安排了几种容易混淆的输入:账户 1 有两笔已付款订单和一笔草稿;账户 2 只有草稿;账户 3 完全没有订单;账户 4 有一笔状态为 NULL 的真实订单;账户 5 停用但有付款;账户 6 只有一笔已付款订单,备注为空。改完 SQL 后不要只看账户 1,它恰好是错误写法也能算对的那种。
2. 为什么写了 LEFT JOIN 还是少行
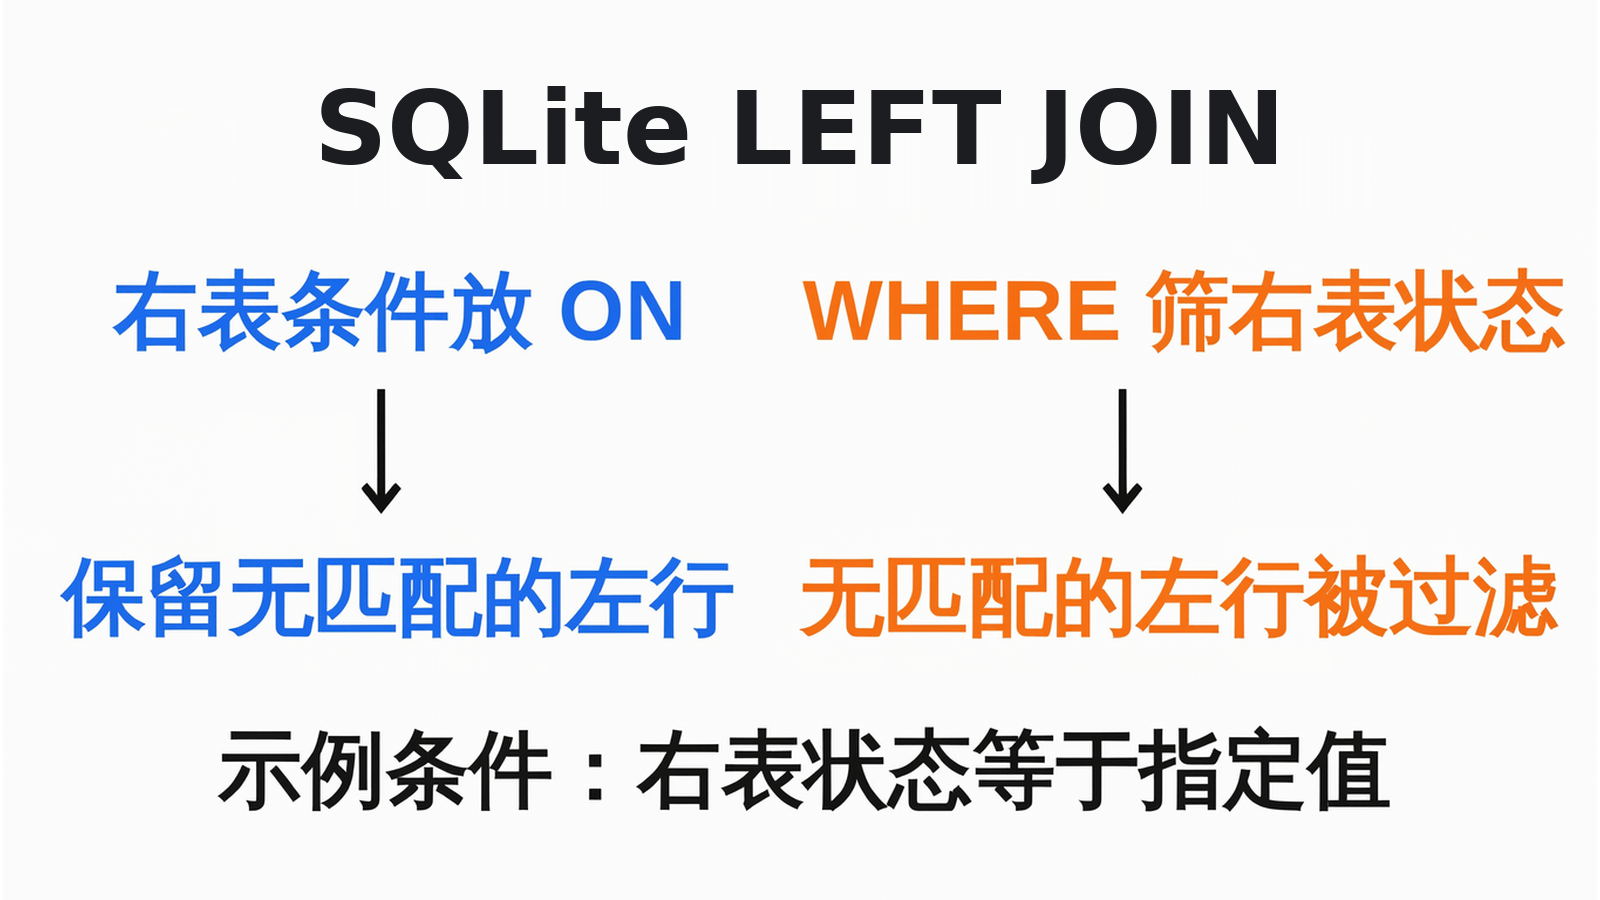
按查询的语义理解,ON 先决定哪些左右记录算匹配。如果某条左表记录没有匹配项,左连接为它保留一行,右边的列用 NULL 补齐。随后 WHERE 过滤连接结果,只保留条件为真的行。补齐行上的 o.status = 'paid' 不为真,而是未知;真实订单的状态本身为空时,这个等式同样不为真。[1][3]
状态条件在 WHERE 时,账户 2 已经在连接阶段匹配到草稿,因此不会得到一行补齐记录。之后草稿被过滤,该账户就一行也不剩。账户 3 虽然拿到补齐记录,最后也过不了状态等式。两条路都走向缺行,只是理由不同。对这种必须有右表非空值才能满足的过滤条件,SQLite 有时还会把外连接简化为普通连接;这是优化,不是报表少行的另一个原因。[1]
3. 把条件放到它负责的地方
把 o.account_id = a.id AND o.status = ? 一起放进 ON,意思是「只连接属于当前账户、且状态等于指定值的订单」。没有符合项的账户仍有一行,只是右表列为 NULL。把 a.enabled = 1 留在 WHERE,才是真的不要停用账户;如果也把它塞进 ON,停用账户匹配不到订单,却仍会以补齐行出现。
接下来用右表不会为空的订单主键做计数。COUNT(*) 统计组里的行数,含补齐行,所以账户 2、3、4 各得到 1;COUNT(o.id) 只数非空主键,得到的才是匹配订单数。也别顺手改成 COUNT(o.note):账户 6 的订单确实存在,备注为空并不会让那笔付款消失。[2]
4. 在空白内存库里验证十种结果
把下面整段存为 left_join_demo.py,用带 sqlite3 模块的 Python 3 运行;不需要 SQLite 命令行、第三方包或现有数据库。脚本会先输出实际加载的 SQLite 版本,再逐项对照查询结果,出现不同就报错。前七项每行的四列分别是账户 ID、非空订单主键数、连接后行数和非空备注数。实际报表通常只选第一、二列,其余两列留给这次诊断。
import sqlite3
from contextlib import closing

with closing(sqlite3.connect(':memory:')) as db:
    db.executescript('''
        CREATE TABLE account(id INTEGER PRIMARY KEY, enabled INTEGER NOT NULL);
        CREATE TABLE orders(id INTEGER PRIMARY KEY, account_id INTEGER NOT NULL,
                            status TEXT, note TEXT);
        INSERT INTO account VALUES (1,1),(2,1),(3,1),(4,1),(5,0),(6,1);
        INSERT INTO orders VALUES (10,1,'paid',NULL),(11,1,'paid','ok'),
            (12,1,'draft',NULL),(20,2,'draft',NULL),(40,4,NULL,NULL),
            (50,5,'paid',NULL),(60,6,'paid',NULL);
    ''')
    start = ' FROM account a LEFT JOIN orders o ON o.account_id = a.id '
    end = ' GROUP BY a.id ORDER BY a.id'
    cols = 'SELECT a.id, COUNT(o.id), COUNT(*), COUNT(o.note)'
    good = cols + start + 'AND o.status = ? WHERE a.enabled = 1' + end
    bad = cols + start + 'WHERE a.enabled = 1 AND o.status = ?' + end
    patched = cols + start + '''WHERE a.enabled = 1
        AND (o.status = ? OR o.id IS NULL)''' + end
    left_filter_in_on = cols + start + 'AND o.status = ? AND a.enabled = 1' + end
    missing = cols + start + 'WHERE a.enabled = 1 AND o.status IS NULL' + end
    inner = bad.replace('LEFT JOIN', 'INNER JOIN')
    groups = [(1,2,2,1), (2,0,1,0), (3,0,1,0), (4,0,1,0), (6,1,1,0)]
    paid = [(1,2,2,1), (6,1,1,0)]
    cases = [
        ('right filter in ON', good, ('paid',), groups),
        ('right equality in WHERE', bad, ('paid',), paid),
        ('inner join matches the broken result', inner, ('paid',), paid),
        ('OR id IS NULL only restores the no-child account', patched,
         ('paid',), [paid[0], (3,0,1,0), paid[1]]),
        ('left filter in ON does not exclude a disabled account', left_filter_in_on,
         ('paid',), groups[:-1] + [(5,0,1,0), groups[-1]]),
        ('IS NULL keeps both no-child and actual NULL-status rows', missing,
         (), [(3,0,1,0), (4,1,1,0)]),
        ('no rows match the chosen status', good, ('refunded',),
         [(i,0,1,0) for i in (1,2,3,4,6)]),
        ('HAVING intentionally drops zero-count groups',
         good.replace('ORDER BY', 'HAVING COUNT(o.id) > 0 ORDER BY'), ('paid',), paid),
        ('EXISTS intentionally returns only accounts with paid orders',
         '''SELECT a.id FROM account a WHERE a.enabled = 1 AND EXISTS (
              SELECT 1 FROM orders o WHERE o.account_id = a.id AND o.status = ?)
            ORDER BY a.id''', ('paid',), [(1,), (6,)]),
        ('preaggregation returns zero via COALESCE',
         '''SELECT a.id, COALESCE(o.n, 0) FROM account a LEFT JOIN (
              SELECT account_id, COUNT(*) AS n FROM orders
              WHERE status = ? GROUP BY account_id
            ) o ON o.account_id = a.id WHERE a.enabled = 1 ORDER BY a.id''',
         ('paid',), [(1,2),(2,0),(3,0),(4,0),(6,1)]),
    ]
    print('SQLite', sqlite3.sqlite_version)
    for label, sql, args, expected in cases:
        actual = db.execute(sql, args).fetchall()
        if actual != expected:
            raise RuntimeError(f'{label}: expected {expected!r}, got {actual!r}')
        print(f'{label}: {actual}')
    print(f'{len(cases)} checks passed')
正确写法保留了账户 1、2、3、4、6,计数依次为 2、0、0、0、1。错误写法只留下 1 和 6,和本实验中的内连接对照一致。把查询状态改成样本中没有的 refunded,也应照常看见五个启用账户,只是全为零。这个用例比只测「有付款」更能发现回归。运行只验证内存数据上的查询结果,不代表生产统计口径、查询耗时或索引已经验收。
5. 补一个 OR,为什么只救回一部分
WHERE o.status = ? OR o.id IS NULL 确实救得回账户 3,因为它压根没连到订单,右侧主键就是空的。但账户 2 的草稿已经有主键,账户 4 的空状态订单也有主键,两者都过不了这两个条件。过滤完之后,数据库不会回头重新给它们补一行。条件应该从连接时就限定匹配对象,而不是等结果出来再补漏。
反过来,也不要总结成「右表字段不能出现在 WHERE」。如果报表要找状态为空的行,WHERE o.status IS NULL 本来就可能保留补齐行和真实的空状态订单。若只想找没有匹配记录的账户,应检查补齐时必为空、真实匹配时必不为空的列,例如样例的订单主键,并先确认 ON 中定义的是「任何订单」还是「已付款订单」。如果目的是只列有付款的账户,EXISTS 或只保留计数大于零的分组更能说清需求。
6. 按症状查,别先加 DISTINCT
| 现象 | 先看什么 | 怎样验 |
|---|---|---|
| 只有草稿的账户消失 | 右表状态等式是否写在 WHERE | 将匹配条件放进 ON,读回应为零的账户 ID |
| 没订单的账户显示 1 | 用了 COUNT(*),实际数到了补齐行 | 对照 COUNT(o.id),确认订单主键不为空 |
| 停用账户也出现 | 账户筛选是否误放 ON | 把账户条件留给 WHERE,核对输出集合 |
| 再连明细表后,订单数变多 | 同一个订单是否匹配了多行明细 | 先看每个账户对应的订单 ID 有没有重复,再决定计数粒度 |
最后一行是另一个常见坑。比如一张订单有两条明细,又连了一张记录明细的表,COUNT(o.id) 就会按连接结果数两次。若只要账户级订单统计,可以先在订单子查询里按账户聚合成每账户一行,再左连回账户并用 COALESCE 把缺失聚合值转成 0。随文实验验证了先聚合的等价结果,没有模拟额外明细表;后续若再连一对多,仍需核对输出是否膨胀。若业务认定每个订单 ID 只计一次,也可以评估 COUNT(DISTINCT o.id),但它不会修好查错的关联键。
线上排查可以先在只读副本挑一个已知少行的账户,保留原查询的关联键,暂时展开成订单明细,观察账户 ID、订单 ID、订单状态这三列。看到右侧 ID 为 NULL,才是这个连接没匹配上;看到真实 ID 而状态不对,则是有订单但不符合统计条件。测试时把相同条件放进两份查询,分别比对明细和分组,别一开始就对着一张总表猜。
如果查询由报表工具拼装,特别要读它最终生成的 SQL:界面上的同一个「状态」下拉框,有的会给整个查询加 WHERE,而不是给订单连接补 ON 条件。可以先在查询层把「已付款订单数」做成固定含义的一列,再让工具筛账户属性;需要按统计结果筛选时,另加明确的计数条件。这比在看板上补几条默认值更容易测试。
7. 发布报表前对两张清单
第一张是应出现的账户清单,第二张是每个账户的预期计数。测试时既要有完全没订单的账户,也要有订单存在但全都不合条件的账户,再加一个本来就不该出现的停用账户。不要只拿总计比对:漏掉一个账户、另一个账户多算一笔,屏幕上的总数可能还挺整齐。
- 核对账户 ID 集合,再逐账户比对 0、1 和多笔结果。
- 分别覆盖右表字段为空、真实右表行不存在、以及全部状态不匹配。
- 追加一对多连接前先确认统计粒度,改索引前另用代表性数据测执行计划和耗时。
🔕 评论已关闭