接口请求写了 timeout=5,却十几秒还没结束;把数字改小后,下载又频繁断开。这里先别怪线程:在 Python Requests 中,timeout 主要控制连接等待和读取空档,并不是整次请求的总秒表。下面用一个本机隔离实验拆清边界,再给出带软预算和大小限制的读取方式。
一、先分清三个时钟
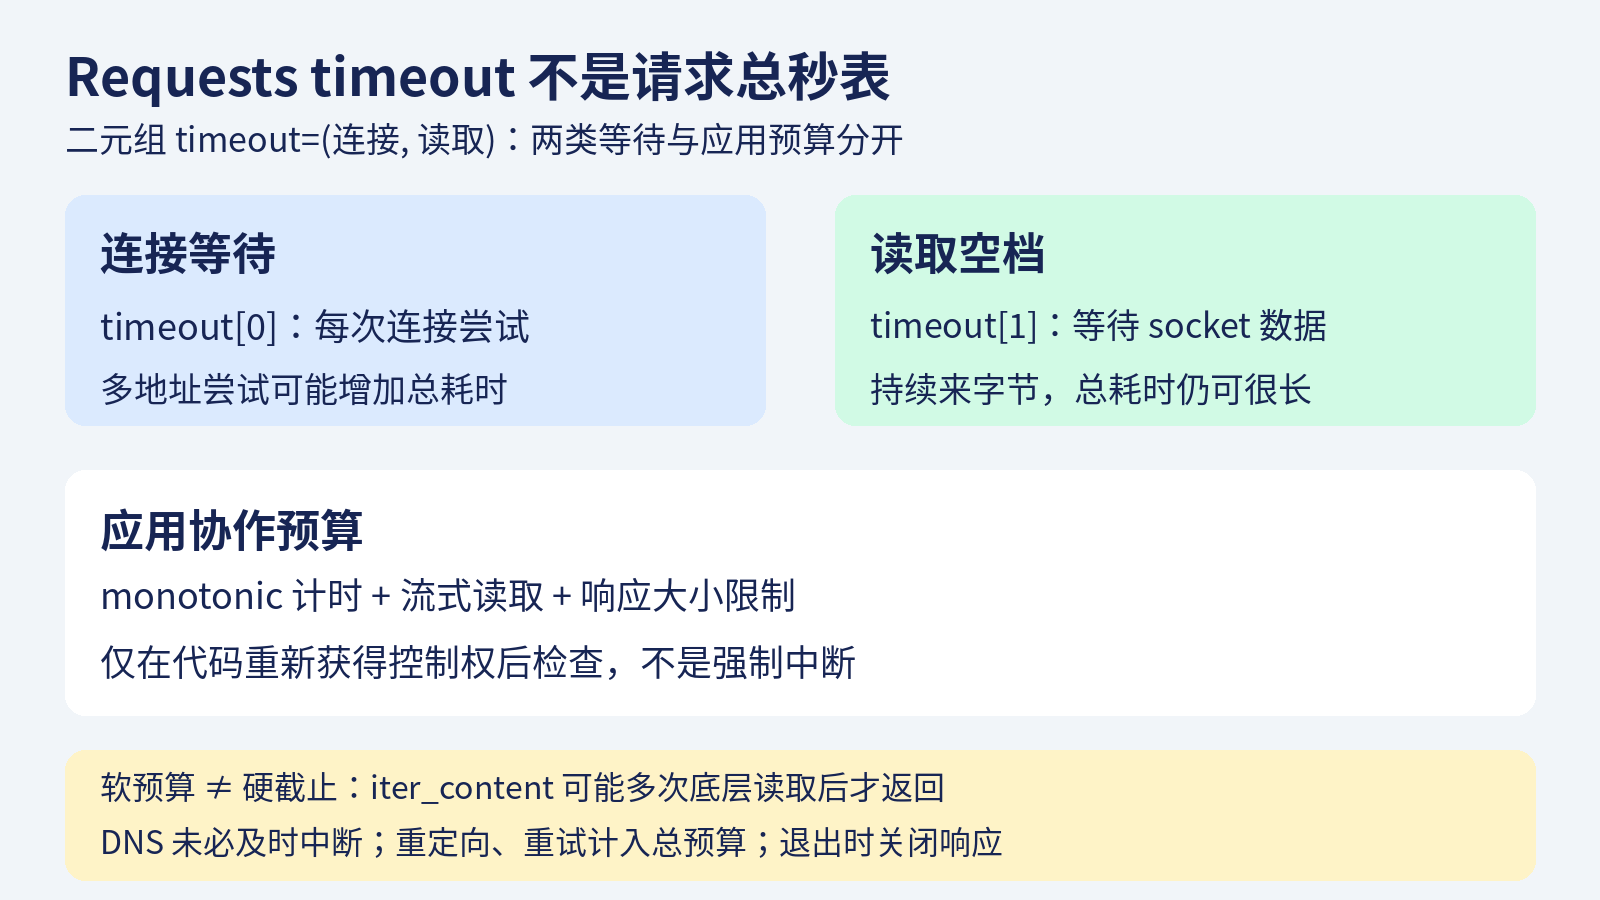
连接超时限制建立连接的等待;读取超时限制底层 socket 读取等待,不是从首字节到完整正文的总时长。一个数字同时设置这两项,元组则分别设置。例如 timeout=(3, 1) 并不表示“请求最多四秒”。服务端只要不断发送数据,完整下载可能明显超过这两个数字。
第三个时钟才是业务关心的总预算:排队、DNS、连接、读取、解析、重试都可能消耗它。Requests 官方明确说明连接和读取超时不是 wall clock;urllib3 也提示,Python 的 DNS 解析并不服从 socket 超时。换成名叫 total 的参数,也不能直接承诺整段下载有硬截止。
二、用慢响应解释“为什么没退出”
本次实验只启动本机临时 HTTP 服务,没有请求生产接口。它每隔约 0.05 秒发送一个字节,共发送 12 字节。客户端读取超时设为 0.2 秒,最终成功收完,实测总耗时约 0.553 秒:字节间隔没有超过读取等待限制,但总下载时间已经超过它。
import requests

with requests.get("https://api.example/data",
                  timeout=(3, 1)) as 响应:
    响应.raise_for_status()
    print("正文长度:", len(响应.content))
上面的安全占位地址需要替换为你有权访问的测试服务。默认 stream=False 会先下载正文再返回;所以代码停在 get(),不等于连接阶段一直没完成。实验环境为 Python 3.14.3、Requests 2.34.2、urllib3 2.7.0(本机安装版本)。
三、先拆开连接和读取等待
先设置两项等待,再判断异常发生在哪一段。连接失败关注路由、代理和目标地址;迟迟没有响应头关注服务端处理与读取等待;已经收到响应头、随后正文停顿,则关注流式下载。不要因为一个异常名称就认定所有问题发生在连接阶段。
本机夹具中,等待响应头停顿触发 ReadTimeout;开启 stream=True 后,正文读取停顿在这组依赖版本中包装成 ConnectionError。故而只捕获 Timeout 可能漏掉部分流式读取失败。网络错误可先按 RequestException 兜底,记录异常链和当前阶段,再细分处理;不要把所有 ConnectionError 都断言为超时。
四、为小响应加软预算和大小限制
下面是小型 API 响应的协作式保护:默认不跟随重定向,只收 2xx;读取时统计解码后的正文长度,并在代码获得控制权后检查单调时钟。示例使用 Python 3 的中文标识符,功能代码与本次隔离测试保持一致。
import time
import requests


def 限量读取(地址, 总预算=10.0, 最大字节=1048576):
    截止 = time.monotonic() + 总预算
    with requests.get(
        地址, timeout=(3.0, 1.0), stream=True,
        allow_redirects=False,
    ) as 响应:
        响应.raise_for_status()
        if not 200 <= 响应.status_code < 300:
            raise ValueError("只接受 2xx,不自动跟随重定向")
        内容 = bytearray()
        for 分块 in 响应.iter_content(chunk_size=1024):
            if time.monotonic() >= 截止:
                raise TimeoutError("应用预算已耗尽")
            if len(内容) + len(分块) > 最大字节:
                raise ValueError("响应超过大小限制")
            内容.extend(分块)
        if time.monotonic() >= 截止:
            raise TimeoutError("应用预算已耗尽")
        return bytes(内容)
with 会在异常时关闭响应,避免未读完的连接悬着。大小按 iter_content 返回的解码后字节统计;不能仅相信 Content-Length,因为它可能不存在,压缩前后的长度也不同。这里限制的是最终收集内容,并不承诺所有解压中间内存都有严格上限。大文件应流式写入受控临时文件,而不是攒在 bytearray 中。
五、别把软预算包装成硬截止
关键限制在 for 循环的入口:iter_content 要先返回一块数据,代码才能检查时间。chunk_size=1024 不是“收到一个网络包立即回调”;持续来的小字节可能被累积后才交给应用。减小块大小能提高检查机会,但不能强制打断 DNS 或正在进行的阻塞读取。
隔离实验把总预算设为 0.15 秒;持续小字节响应仍在约 0.553 秒后才抛出应用 TimeoutError,证实预算可能超出。这个函数负责“拿回控制权后拒绝继续接受结果”,不是“保证第 0.15 秒结束”。如果业务必须限制占用时间,应评估可取消的客户端或独立工作进程,并验收取消、终止和资源清理。
也别用 Future.result(timeout=...) 假装任务被取消:调用方停止等待不等于底层线程停止请求。进程终止同样不代表远端业务回滚;涉及写操作时,要靠幂等标识与服务端查单确认结果,而不是仅看客户端是否超时。
六、重试和重定向要共享预算
每轮都给 timeout=(3, 1),再循环十次,整体等待仍可能很长。应从同一个截止时间计算剩余预算,为连接、读取、退避分别留量;预算耗尽就停止新尝试。本文函数没有配置自动重试,也没有提供重试承诺,避免把单次读取和整体调度混在一起。
重定向亦会增加请求链。示例显式关闭自动跟随,并拒绝 3xx;实际业务需要跳转时,应验证目标、限制次数且继续使用同一预算。只读 GET 也不值得无限重试;POST 超时不能推出服务端没执行,没查清结果就补发,容易把超时排查变成重复扣账排查。
七、按现象选失败分支
| 现象 | 优先检查 | 避免的误判 |
|---|---|---|
| 总耗时大于 timeout | 持续来字节、DNS、多地址和跳转 | 认定参数完全失效 |
| 正文中途停顿 | 流式读取阶段与异常链 | 只捕获 Timeout |
| 内存不断上涨 | 收集方式、解码后长度 | 只检查 Content-Length |
| 调用方已超时,任务仍跑 | 取消与执行隔离 | 把停止等待当停止任务 |
还有一个常见误区:把下载耗时、处理耗时、排队耗时混成一条日志。建议为每一阶段留独立记录,先定位慢在哪里,再讨论该缩短哪一项等待;不必一上来就把所有数字调小。
八、上线前用这份清单验收
分别测试正常响应、响应头停顿、正文停顿、连续小字节、超大正文、HTTP 错误与重定向。本次九项隔离检查全部通过,还覆盖空正文结束后的预算检查。实验只能证明这些本机分支,不能证明真实外部服务的 DNS、代理、TLS 或远端幂等已经验收。
记录总耗时、当前阶段、异常类型、读取字节数和尝试次数;日志不保存鉴权头与敏感正文。检查超限后响应是否关闭、是否留下半成品、是否继续重试。最终要回答两件事:单次等待有没有限制,整个任务何时放弃;别让一个 timeout 数字替两份契约背锅。
🔕 评论已关闭