Python 脚本只调用了一次 logger.info,终端却出现两行;把初始化放进函数后,调用次数越多,重复行也越多。别先给日志做字符串去重:问题常在处理器挂载和传播链。下面用标准库 logging 拆开两类重复,并给出不改生产配置的诊断方法。
一、先确认重复的是日志,还是业务
同样的文字出现两次,不足以证明业务执行了两次。先给格式加上进程号、日志器名称和业务事件标识,再用一条固定消息测试。相同进程、同一事件在不同格式里出现,优先检查处理器;不同进程都有输出,先查 worker、重载器或任务派发。别拿日志行数直接当订单数,账本可不会陪你猜谜。
本文实验在独立 Python 3.14.3 进程和内存缓冲中完成,未更改线上服务。基本传播规则不是这个版本的新功能。这里只处理进程内输出链路,不承诺解决所有采集端重复。
二、一条记录可以有两个出口
日志器负责产生记录,handler 负责输出。demo.worker 挂一个处理器,root 再挂一个;默认 propagate=True 时,本地先处理,再向祖先处理器传播。两处都满足条件,就会输出两次。相同名称的 getLogger 返回同一个对象,反复获取不是复制日志器;反复创建新 handler 再添加,才容易越配越多。
下面只在全新测试进程运行,不能粘进正在工作的应用进程。预期缓冲里出现两行相同文字。
import io, logging
缓冲 = io.StringIO()
根 = logging.getLogger()
根.addHandler(logging.StreamHandler(缓冲))
子 = logging.getLogger("demo.worker")
子.setLevel(logging.INFO)
子.addHandler(logging.StreamHandler(缓冲))
子.info("只调用一次")
print(缓冲.getvalue())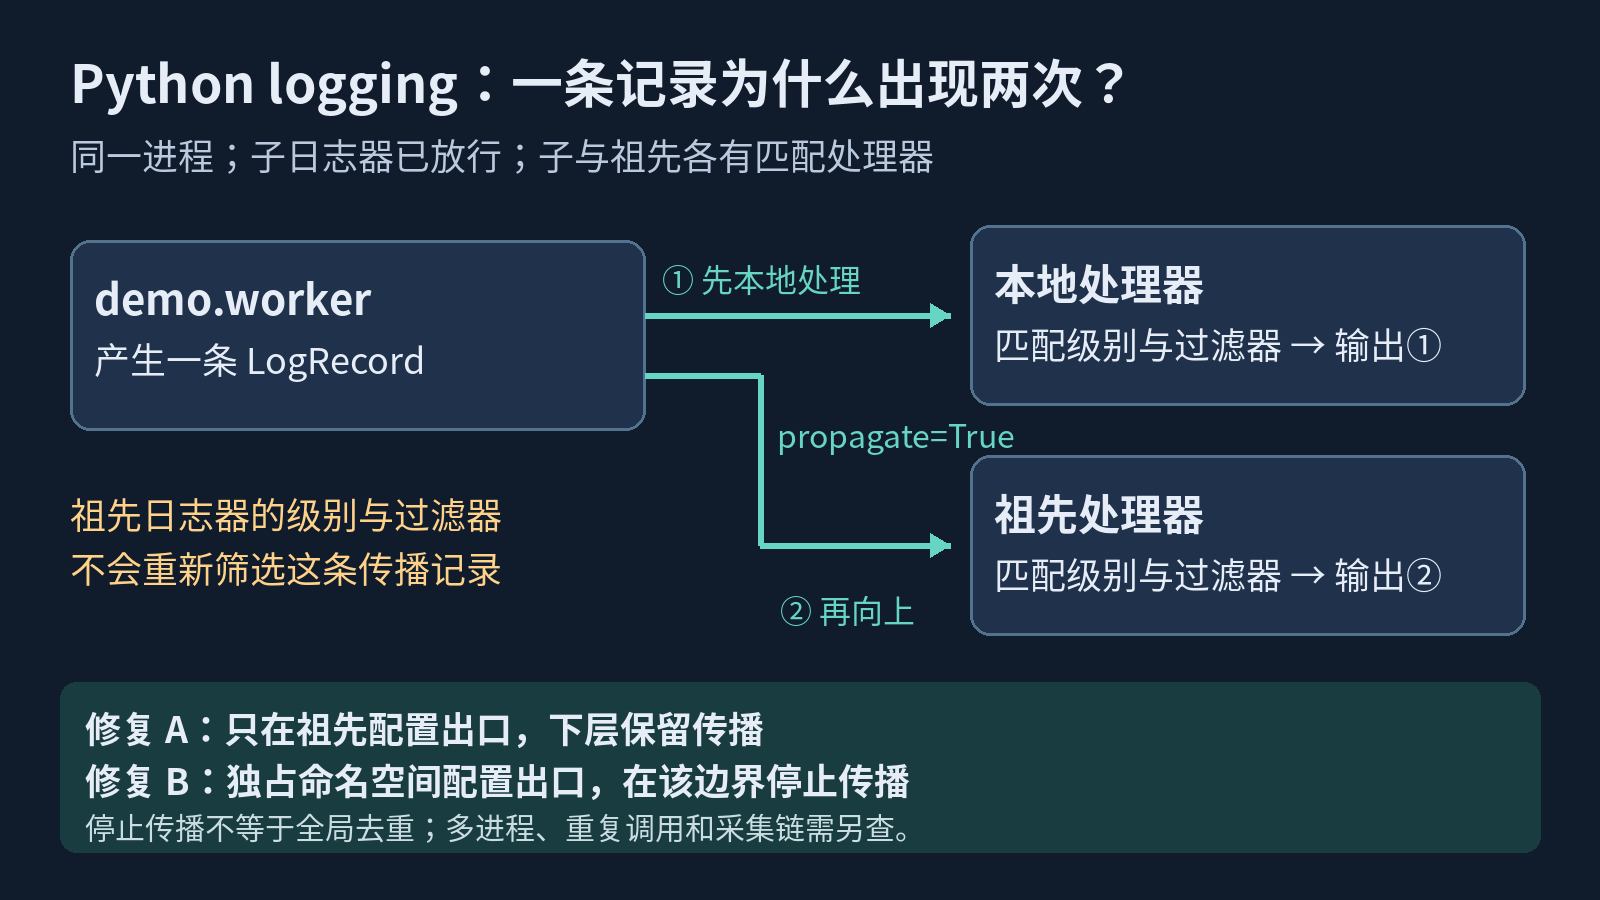
三、沿实际 parent 链找处理器
把下面函数放进待排查应用,在启动配置完成后调用,传入你真正使用的日志器。重新开一个空 Python 进程只能看到新进程的配置,不能证明线上链路正常。检查名称、传播开关、本地处理器类型与级别;对象标识可帮助辨认同一个 handler 是否挂在两层。
def 查看链路(日志器):
    while 日志器 is not None:
        print(日志器.name, 日志器.propagate,
              [(type(h).__name__, h.level, id(h))
               for h in 日志器.handlers])
        if not 日志器.propagate:
            break
        日志器 = 日志器.parent
遍历 parent 比拆名称可靠,因为父节点可能随后才被创建。同一个处理器对象同时挂在子与祖先上,也可能被调用两次,logging 不会沿整条链自动按对象去重。诊断只打印配置,不删处理器;文件路径、日志内容和请求参数不要直接贴到公开页面。
四、选一个出口所有者,不要全链乱关
普通独立应用可由入口统一配置 root,业务模块只 getLogger(__name__) 并写日志,不自行添加控制台处理器。另一种方案是应用独占一个顶层命名空间,在此配置出口并停止向 root 传播。两种方式各有用途,关键是明确谁管理输出,而不是给所有子日志器一律设 False。
下面演示第二种,前提是 demo 由本应用独占,下层日志器没有自行配置处理器且保留传播。只在主线程启动阶段调用,不用于并发热配置。重复串行调用不会追加同名处理器;它不是清理器,不能自动移除之前已挂上的其他出口。
import logging

def 初始化日志():
    日志器 = logging.getLogger("demo")
    日志器.setLevel(logging.INFO)
    日志器.propagate = False
    if not any(h.get_name() == "demo-console"
               for h in 日志器.handlers):
        处理器 = logging.StreamHandler()
        处理器.set_name("demo-console")
        处理器.setLevel(logging.INFO)
        处理器.setFormatter(logging.Formatter(
            "%(process)d %(name)s %(levelname)s %(message)s"))
        日志器.addHandler(处理器)

初始化日志()
logging.getLogger("demo.worker").info("只应出现一次")
如果确认旧处理器归本应用管理,才用 removeHandler 后 close 释放;不得直接清空框架的 handlers。处理器名称是本例的所有权约定,不是 Python 自动识别业务归属的机制。想保留文件和控制台两个不同目的地,可以配置两个出口;这不算同一目的地的错误重复。
五、三个看似省事的修法有边界
第一,hasHandlers() 会沿祖先查找,并不等于“自己已配置”。root 有处理器时,子日志器本地列表为空也可能返回 True;本地检查应看 handlers,所有权检查再结合名称。
第二,把 root 级别改成 ERROR,不一定挡住已由 INFO 子日志器放行的记录。传播直接交给祖先处理器,祖先日志器的级别和过滤器不会再筛一遍;处理器自身的级别和过滤器仍有效。未设置独立级别的子日志器则可能继承祖先级别,别混为一谈。
第三,basicConfig 在 root 已有处理器时默认不重配。Python 3.8 起支持 force=True,但它会移除并关闭根处理器,不清理子日志器出口。不要在被框架托管的服务里把它当通用重置键。停止传播且没有处理器时,WARNING 以上还可能由 lastResort 输出,不能据此推断传播没关掉。
六、按现象分流,不用文本去重掩盖错误
| 现象 | 优先检查 | 下一步 |
|---|---|---|
| 同一事件固定两行 | 子与祖先是否都挂出口 | 保留一个明确的所有者 |
| 每次初始化多一行 | 是否反复创建新 handler | 启动配置集中化并检查所有权 |
| 不同进程各打一行 | worker 或重复派发 | 结合事件标识核验业务调用 |
| 本地一行,平台两行 | 标准输出与文件是否双重采集 | 比较采集来源和记录标识 |
| 关传播后日志消失 | 边界是否缺有效处理器 | 补出口并测试各级别 |
多进程写同一个文件还涉及同步与轮转,不能由这段初始化函数兜底。官方 Cookbook 给出集中监听与队列方案;迁移前仍要检查异常、退出刷盘和采集端规则,别仅凭终端安静了就上线。
七、验收要同时覆盖重复与漏记
隔离实验完成 13 项检查:双出口、重复挂载、祖先判断、祖先级别与处理器级别差异、同一处理器跨层挂载、十次初始化和 lastResort 等分支。修复例连续初始化十次,本地仍只有一个处理器,单次 INFO 输出一行,DEBUG 未输出。
- 在目标应用启动后盘点传播链,不把空进程的结果当上线证据。
- 连续初始化后处理器数量不增长,单个测试事件在每个预期目的地各出现一次。
- INFO、WARNING、ERROR 与异常堆栈按预期保留,不以关闭所有输出换取“不重复”。
- 区分多进程业务调用与采集重复,修改后检查文件、控制台和最终平台。
八、参考与最后的判断
参考 Python logging 官方文档与 Logging Cookbook。排查时先画出实际输出链,再决定配置归属。把重复的出口收拢,比在末端按文字删日志更稳;真正重复执行的业务,则必须回到调度与幂等逻辑解决。
🔕 评论已关闭