批处理脚本想把 report.txt 去掉扩展名,结果却得到 repor;换个文件名又正常。这类问题常藏在 Python 的 rstrip(".txt") 里。本文用可复制的字符串实验区分“删字符集合”和“删完整后缀”,给出 Python 3.9+ 的修复、旧版本写法与回归清单,不对真实文件做改名操作。
一、先用一个会出错的文件名复现
先用 repr() 看原值、结果与尾部空格。将下面代码保存为 probe.py,运行 python3 probe.py;原生方法需要 Python 3.9+。
名称 = "report.txt"
print(repr(名称.rstrip(".txt")))       # 'repor'
print(repr(名称.removesuffix(".txt"))) # 'report'
print(repr("abc.xtt".rstrip(".txt"))) # 'abc'
assert 名称 == "report.txt"           # 原字符串没被修改
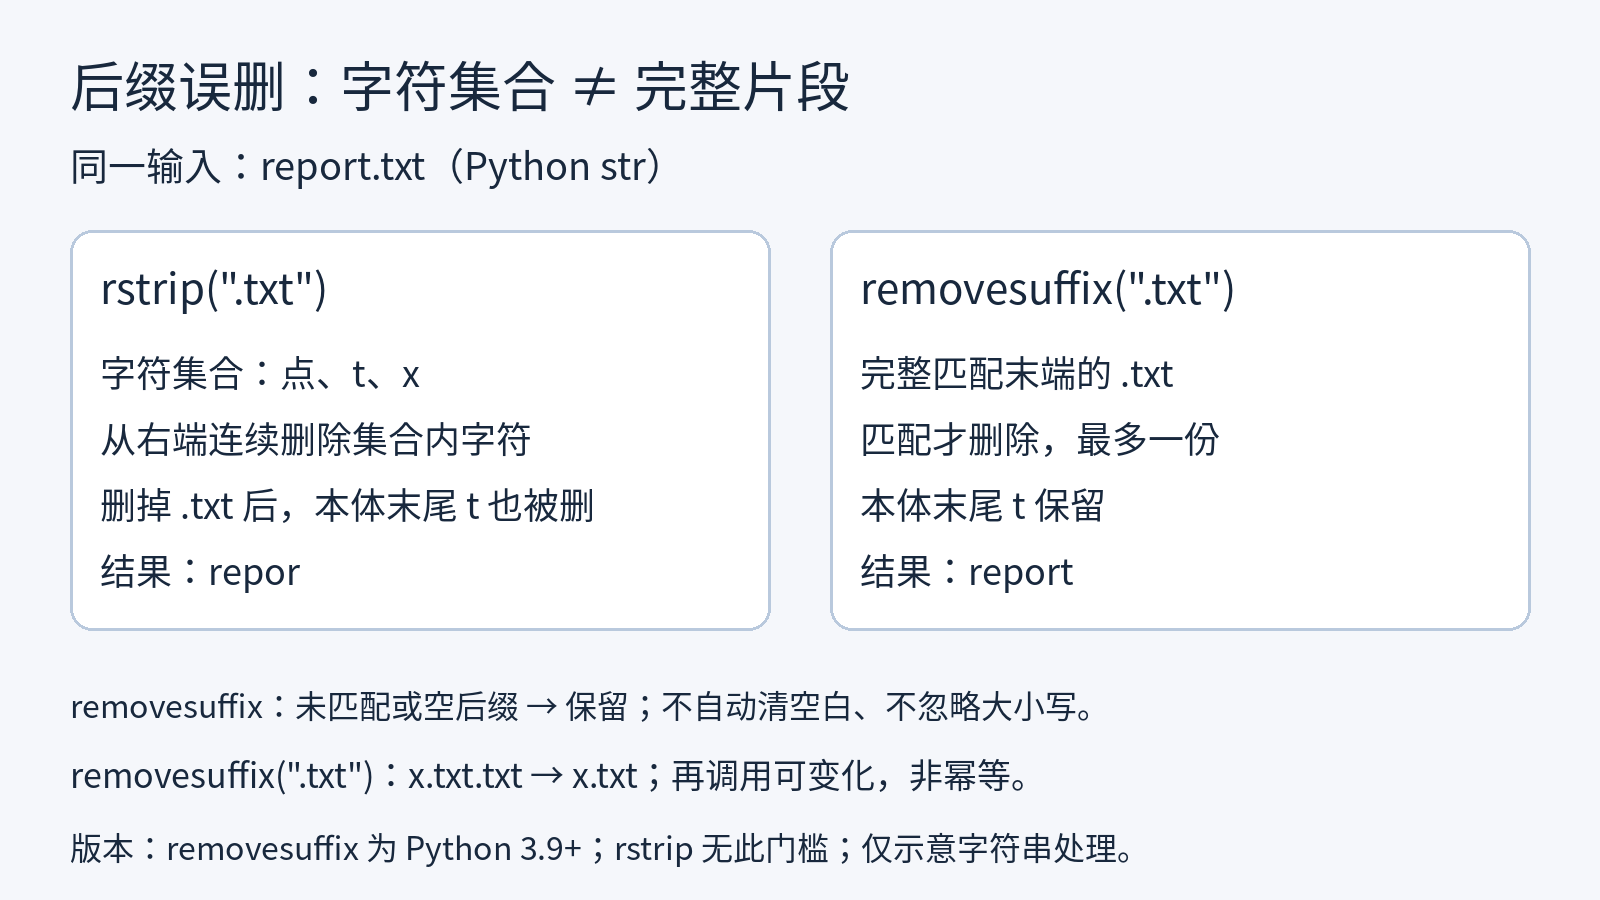
report 本体末尾也是 t,rstrip 连它一起删掉了。只测 hello.txt 会得到正确结果,却漏掉误删;abc.xtt 根本不以 .txt 结束,仍变成 abc,更说明它不是后缀匹配。
二、rstrip 的参数不是一段尾巴
官方文档把 chars 定义为要删除的字符集合。rstrip 从右边开始,只要当前字符属于集合,就继续删除;遇到集合之外的字符才停。参数中字符的排列顺序不表示匹配顺序,重复字符也不增加特殊规则。lstrip 做同类左侧处理,strip 则处理两端。
rstrip(".txt") 就是“从右端连续去掉点、t 或 x”。不传参数或传 None 时默认去除空白,不只普通空格;传空字符串则保持内容。方法返回新值,不原地修改 str,必须接住返回值。
三、完整后缀用 removesuffix,前缀同理
str.removesuffix() 与 str.removeprefix() 从 Python 3.9 加入。前者只在末端完整匹配时删除一次;后者只在开头完整匹配时删除一次。不匹配就保留原内容,不自动报错,也不顺带清理空白。
把名称转换写成 新名称 = 名称.removesuffix(".txt") 即可保留 report 本体。若业务要求必须以 .txt 结束,需要另用 endswith 检查并显式拒绝不匹配输入;“没有抛异常”不代表输入符合协议。前缀也一样:lstrip("pre_") 可能继续吞掉 prefix 的开头,removeprefix 才表达删掉一份 pre_。
别用 replace(".txt", "") 修复:它默认替换所有匹配片段,a.txt.b.txt 会变成 a.b,删除一个后缀却应得到 a.txt.b。限制替换次数也不等于只匹配末端。
四、旧 Python 可以怎样兼容
Python 3.8 及更早版本可先判断再切片。完整实现如下,约定参数均为 str,不负责路径或类型校验。
def 去后缀(文本, 后缀):
    if 后缀 and 文本.endswith(后缀):
        return 文本[:-len(后缀)]
    return 文本

assert 去后缀("report.txt", ".txt") == "report"
assert 去后缀("report.csv", ".txt") == "report.csv"
assert 去后缀("report", "") == "report"
assert 去后缀("x.txt.txt", ".txt") == "x.txt"
后缀 and 必须保留:空后缀长度为零,文本[:-0] 却得到空字符串。缺少判断,空配置可能清空名称。切片长度也别写死为 -4,后缀一改,代码就会脱节。
五、这些边界必须由业务决定
一次删除不等于删到干净。x.txt.txt 调用一次会留下 x.txt;重复调用会继续改变结果。因此,这个转换不保证幂等,任务重试若反复处理已经转换的输出,也可能越删越短。优先保留原始输入,明确每条记录只做哪一次转换。
匹配区分大小写,也不会自动 Unicode 归一化。x.TXT 不会匹配 .txt,x.txt 后面跟着一个空格也不会匹配。若格式规范允许先去尾部空白,必须明确这一层改变;不要无条件 strip 再声称原值没有被动过。对于多段后缀,应决定删除 .gz 还是 .tar.gz,不让函数替你猜。
removesuffix 不接受后缀元组,不能套用 endswith 的参数规则;多个候选的优先级由应用定义。str 与 bytes 不能混用,字节数据须明确解码或用相应字节方法。
六、把反例变成可运行的回归测试
下面的自检与正文一起交付,无需下载内部测试脚本。它验证缺失后缀、重复后缀、大小写、空白、中文、空串以及字符集合反例;任何断言失败,解释器都会以错误退出,不要只看最后有没有打印日志。
用例 = [
    ("report.txt", ".txt", "report"),
    ("report.csv", ".txt", "report.csv"),
    ("x.txt.txt", ".txt", "x.txt"),
    ("x.TXT", ".txt", "x.TXT"),
    ("x.txt ", ".txt", "x.txt "),
    ("abc.xtt", ".txt", "abc.xtt"),
    ("报告.txt", ".txt", "报告"),
    ("", ".txt", ""),
    ("report", "", "report"),
]
for 文本, 后缀, 预期 in 用例:
    assert 文本.removesuffix(后缀) == 预期
assert "pre_prefix".removeprefix("pre_") == "prefix"
assert "pre_prefix".lstrip("pre_") == "fix"
print("9个后缀用例及2个前缀对照通过")
本文在 CPython 3.14.3 隔离运行了三段代码,另补测空字符集合、默认空白、全局替换、重复调用、零长度切片、元组拒绝和类型拒绝,共 23 项检查通过。兼容函数在该解释器执行,不冒称已在每个旧 Python 上测试。上述证据只证明内存字符串行为,不证明真实批量改名安全。
七、按症状排查,不要一上来批量替换
| 现象 | 检查点 | 处理方向 |
|---|---|---|
| 本体末尾少了字母 | 是否使用 rstrip(chars) | 改用完整后缀匹配 |
| 没有后缀仍被删字 | 输入是否只是字符集合命中 | 保留不匹配输入或明确拒绝 |
| 转换后仍有一份后缀 | 是否存在重复后缀 | 确定只删一次还是业务需循环 |
| 看似相同却没匹配 | repr、大小写、尾部空白 | 先定义格式,不默认归一化 |
| AttributeError | 运行解释器是否低于3.9 | 核对实际版本或用兼容函数 |
| 处理结果没有变化 | 是否忽略了返回值 | 显式接住新字符串 |
批处理先只读预览:保存原名称与新名称,检查空结果、同名映射与目标已存在。字符串处理正确,不替代文件权限、路径归属及覆盖策略验收;别直接接到真实重命名命令上。
八、上线前最后核对与参考资料
- 运行时版本满足原生方法门槛,实际执行入口与测试入口一致。
- 完整匹配、缺失、空串、大小写、空白、重复后缀全部有预期值。
- 接住返回值,保留原输入;重试不会对已经转换的结果盲目再删。
- 若涉及文件操作,另审目标碰撞、覆盖拒绝、权限与可恢复记录。
清理字符集合时 rstrip 本来就合适;删除完整边界片段,才用 removeprefix 或 removesuffix。让方法与意图一致,不必靠文件名猜谜。
🔕 评论已关闭