配置文件里明明写了 enabled=false,Python 读出来却是 True;没有语法错误,格式化工具也说正常。先检查同一个 JSON 对象里是否写了两遍 enabled。本文用 Python 标准库复现“后值覆盖前值”,给出可直接复制的拒绝重复键读法,再补上字段检查,避免配置悄悄变意思。
一、先复现:原文有两份,字典只剩一份
下面是人工反例。保存为 demo.py,执行 python3 demo.py。结果只有 enabled=True,最先的 false 已不在字典里。
import json

原文 = '{"enabled": false, "enabled": true}'
结果 = json.loads(原文)
print(结果)
assert 结果 == {"enabled": True}
assert json.loads(原文, strict=True) == 结果
json.loads 接受重复名称,保留最后一组同名键值。字典不记录“这里曾写过两次”;只打印解析结果排查,原始冲突已经消失。
二、规范建议唯一,解析器却未必拒绝
RFC 8259 第 4 节写的是对象成员名称 SHOULD 唯一,不是把任何重复名称都规定成必须报错。规范同时提醒,不同实现可能保留最后一组、报错或暴露全部键值对。跨语言系统因此不能默认各方会作同样选择。
Python 官方文档明确说明默认行为。解析器能读入,不代表符合配置约定;要求同对象键唯一,就在入口拒绝。重复键也不必然是攻击,手工合并配置就可能留下它。
三、object_hook 太晚,strict=True 也不管这件事
object_hook 收到的是已经形成的 dict。同名键被合并之后,再检查 len、遍历字典或重新 dumps,无法恢复被丢弃的那一项。object_pairs_hook 收到有序键值对列表,才有机会在变成普通字典之前发现重复。该参数从 Python 3.1 起提供;本文运行证据来自 CPython 3.14.3,不冒称旧解释器实测。
JSONDecoder 的 strict 只控制字符串中未转义控制字符。代码一验证 strict=True 仍接受重复键。两个 hook 同传时 pairs hook 优先;需要对象转换时在 pairs hook 内自行串接。
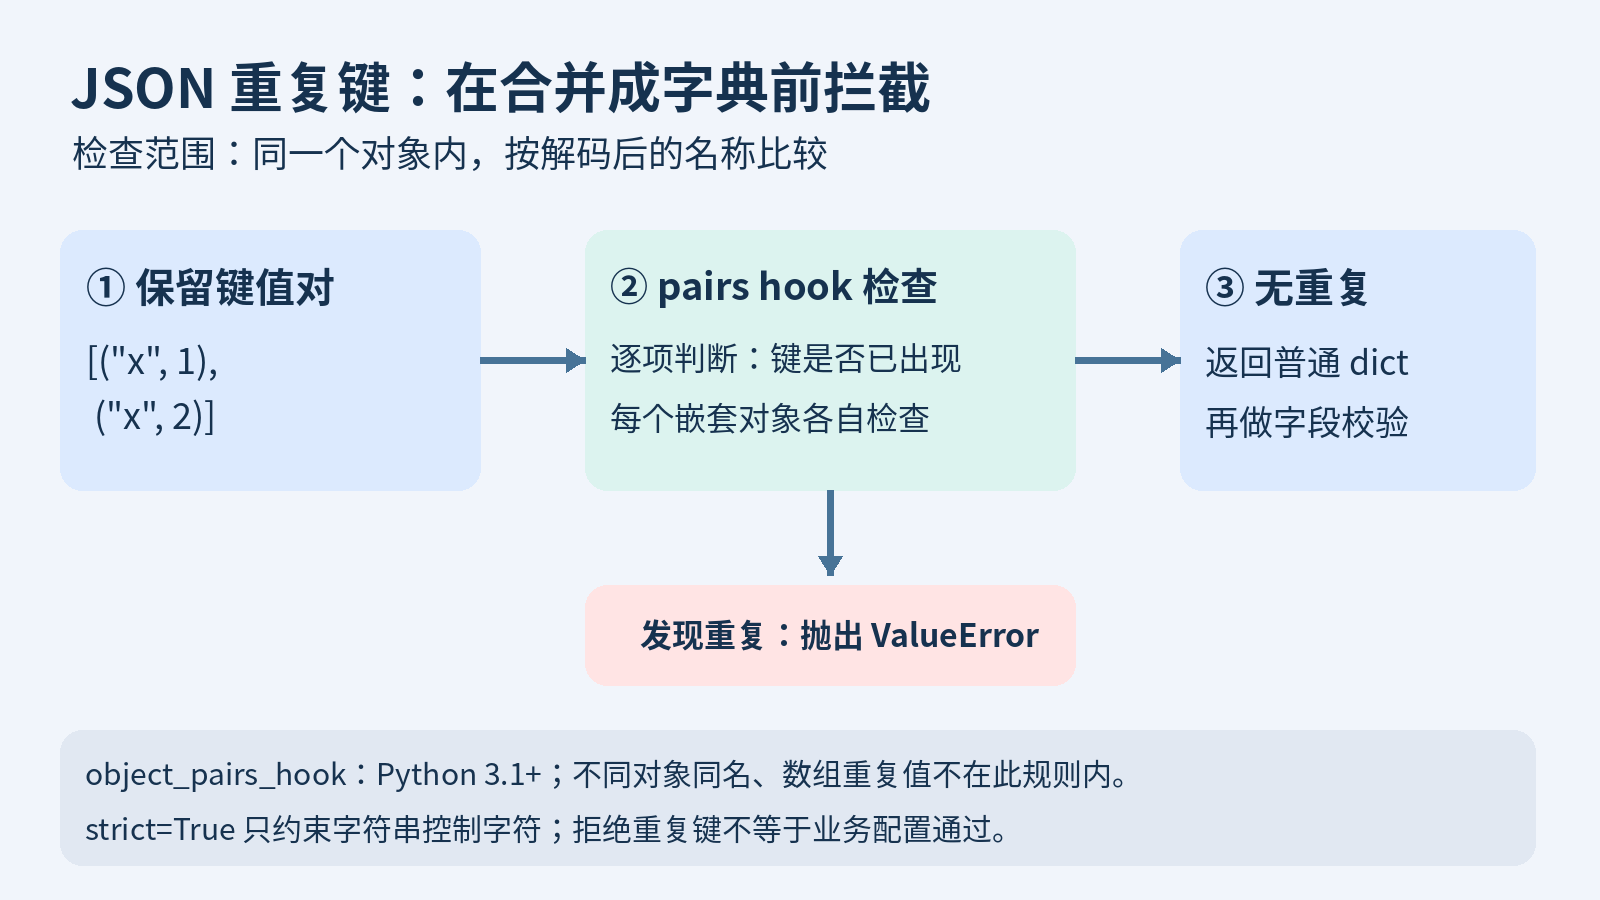
四、完整读法:重复就停,不替读者挑一个值
这段代码可以独立保存并执行,后半段附了最小自检。判断用“键 in 对象”,不要用对象.get(键)的真值:前一个值可能是 null、false 或 0,值为假不代表键没有出现。错误信息也不回显整份配置,避免日志顺带泄露内容。
import json

def 拒绝重复键(键值对):
    对象 = {}
    for 键, 值 in 键值对:
        if 键 in 对象:
            raise ValueError("同一对象存在重复键")
        对象[键] = 值
    return 对象

def 拒绝特殊数值(文字):
    raise ValueError("不接受非标准数值字面量")

def 读取配置(原文):
    return json.loads(
        原文,
        object_pairs_hook=拒绝重复键,
        parse_constant=拒绝特殊数值,
    )

assert 读取配置('{"enabled": false}') == {"enabled": False}
for 原文 in [
    '{"x": null, "x": 1}',
    '{"outer": {"x": 1, "x": 2}}',
    '{"x": NaN}',
]:
    try:
        读取配置(原文)
    except ValueError:
        pass
    else:
        raise AssertionError("应当拒绝该输入")
print("配置读取自检通过")
parse_constant 单独拒绝 NaN、Infinity 和 -Infinity 字面量;它不是重复键检测的必要条件,只是常见配置入口的附加约定。它不会拦住合法数字文本 1e400 转成 float 后的无穷值。若业务要求浮点有限,还需另加数值范围或 math.isfinite 检查,不能把这个函数叫作“全面安全 JSON 解析器”。
五、嵌套对象也要查,数组重复不是重复键
pairs hook 会用于每个解码的 JSON 对象,包括嵌套对象及数组里的对象。{"a":{"x":1},"b":{"x":2}} 可以通过:两个 x 属于不同对象。{"a":{"x":1,"x":2}} 则应拒绝。数组 [1,1] 没有成员名称,不能套用对象的唯一键规则。
名称按解码后的 Python 字符串比较。原文键 "x" 与 "\u0078" 会解码成相同名称,检查应当识别;"X" 与 "x" 不同。视觉相似、大小写折叠或 Unicode 归一化属于另外的业务规则,这个 hook 不替你完成。字段命名规则若要更严格,需单独制定并测试。
六、解析完成之后,再检查类型与范围
没有重复键,不代表配置可以启用。顶层可能是列表,字段可能拼错,retries 也可能是 true。Python 的 bool 是 int 的子类;这里选择 type(次数) is int,明确拒绝把布尔值当重试次数。示例只列两项字段,不是完整配置 Schema。
import json

# 假设重复键检查已在读取入口完成
配置 = json.loads('{"enabled": false, "retries": 3}')
if not isinstance(配置, dict):
    raise ValueError("顶层必须是对象")
if type(配置.get("enabled")) is not bool:
    raise ValueError("enabled 必须是布尔值")
次数 = 配置.get("retries")
if type(次数) is not int or not 0 <= 次数 <= 5:
    raise ValueError("retries 必须是 0 到 5 的整数")
print("字段检查通过")
实际接入时,把第三段的字段验证接在第二段读取结果之后,而不是再用默认 loads 读一次。失败时停止加载新配置并返回明确错误;是否保留上一份配置,由应用自己制定。不要在 except 里返回空字典并报告成功,那只是把问题换了个藏身处。
七、故障分支对照:看原文,不只看格式化结果
| 现象 | 优先检查 | 处理 |
|---|---|---|
| 后值覆盖前值 | 原始文本的同对象键 | 读取入口用 pairs hook 拒绝 |
| strict=True 仍通过 | 混淆控制字符与重复键 | 明确添加重复键规则 |
| null 后重复没拦住 | 使用 get 的真值判断 | 改为键成员测试 |
| 嵌套冲突漏检 | 只手查顶层字典 | 每个对象都由 hook 检查 |
| NaN 被读成浮点数 | 默认支持非标准字面量 | parse_constant 拒绝 |
| 字段通过却执行异常 | 类型、范围和业务约定 | 解析后继续业务验证 |
原始文件若已被默认解析再格式化,重复项无法从新文件恢复。先保留受限权限原件,再修生成来源,不用正则删键。不可信输入还需限量读取并限制解析资源。
八、验收清单与本次测试边界
- 默认 loads 能复现后值覆盖,strict=True 不改变该结果。
- 顶层、嵌套、数组内对象的重复键均被拒绝,包括前值为 null。
- 不同对象的同名键、重复数组值和合法配置仍可读入。
- 转义后同名被拒绝,大小写不同按不同名称处理。
- 缺失字段、错误类型和超出范围继续由业务校验拒绝。
本次用人工字符串隔离测试,并实跑最终 HTML 的三段代码;未验收真实文件迁移、跨语言网关一致性或线上热加载。入口解析与业务检查均通过,才轮到启用配置。
🔕 评论已关闭