把金额写成 round(2.675, 2),结果却是 2.67?这次用 Python 3.14.3 跑了六组对照:保留原始字符串,用 Decimal('2.675') 配合显式舍入可得到 2.68。关键不是再补一次格式化,而是别在入口丢掉十进制含义。
一、先把“两位小数”拆成三个问题
看到少一分钱,直觉很容易把锅扣给舍入函数。我会先拆开看:输入存的究竟是什么数,计算采用什么精度,最后按什么规则输出。这里的 float 保存的是二进制浮点近似值,不是用户输入的那段十进制文本。近似值一旦偏到中点的一侧,后面的舍入就会沿着那一侧走。
“两位小数”也有歧义:界面显示两位、计算结果量化到分、每笔还是合计后才舍入,不是同一件事。排查前先问清楚这些约定,通常比反复换函数更有用。本文只复现数值行为,不把某一种约定当作所有金额业务的标准。
内置float的round在恰好中点时取偶数;本例的2.675却已略低于十进制中点,不能只归因于中点规则。Decimal的显式舍入是另一条可控路径,不是把round改名。
二、Decimal接住的是已有值,不是原输入
把浮点数直接交给 Decimal,不会自动修复输入。实验里打印出的值以 2.674999 开头,严格小于十进制的 2.675。这是对已有二进制浮点值的精确转换,不是转换函数又制造了一份随机误差。官方文档也明确:构造时的上下文精度,不会把这里保存的数字截成指定长度。
另一条常见补救是先转成字符串。对于这个短值,str(2.675) 恰好得到想看到的文本,后续舍入也能得到预期结果。但这不能推广成修复算法:浮点加法已经产生的误差可能继续出现在字符串里,更长原输入中已经丢失的数字也不会回来。数据已经经过浮点链路时,应回到来源确认,而不是猜一个“原始金额”。
三、让原始十进制字符串走进计算链
更稳妥的入口,是让原始十进制字符串直接构造 Decimal,在计算链中继续使用同一数值类型。不要先解析成浮点再补转;也别在中途为图方便转回浮点,最后才重新包装。字符串只是载体,前提是它真来自尚未丢失精度的输入。
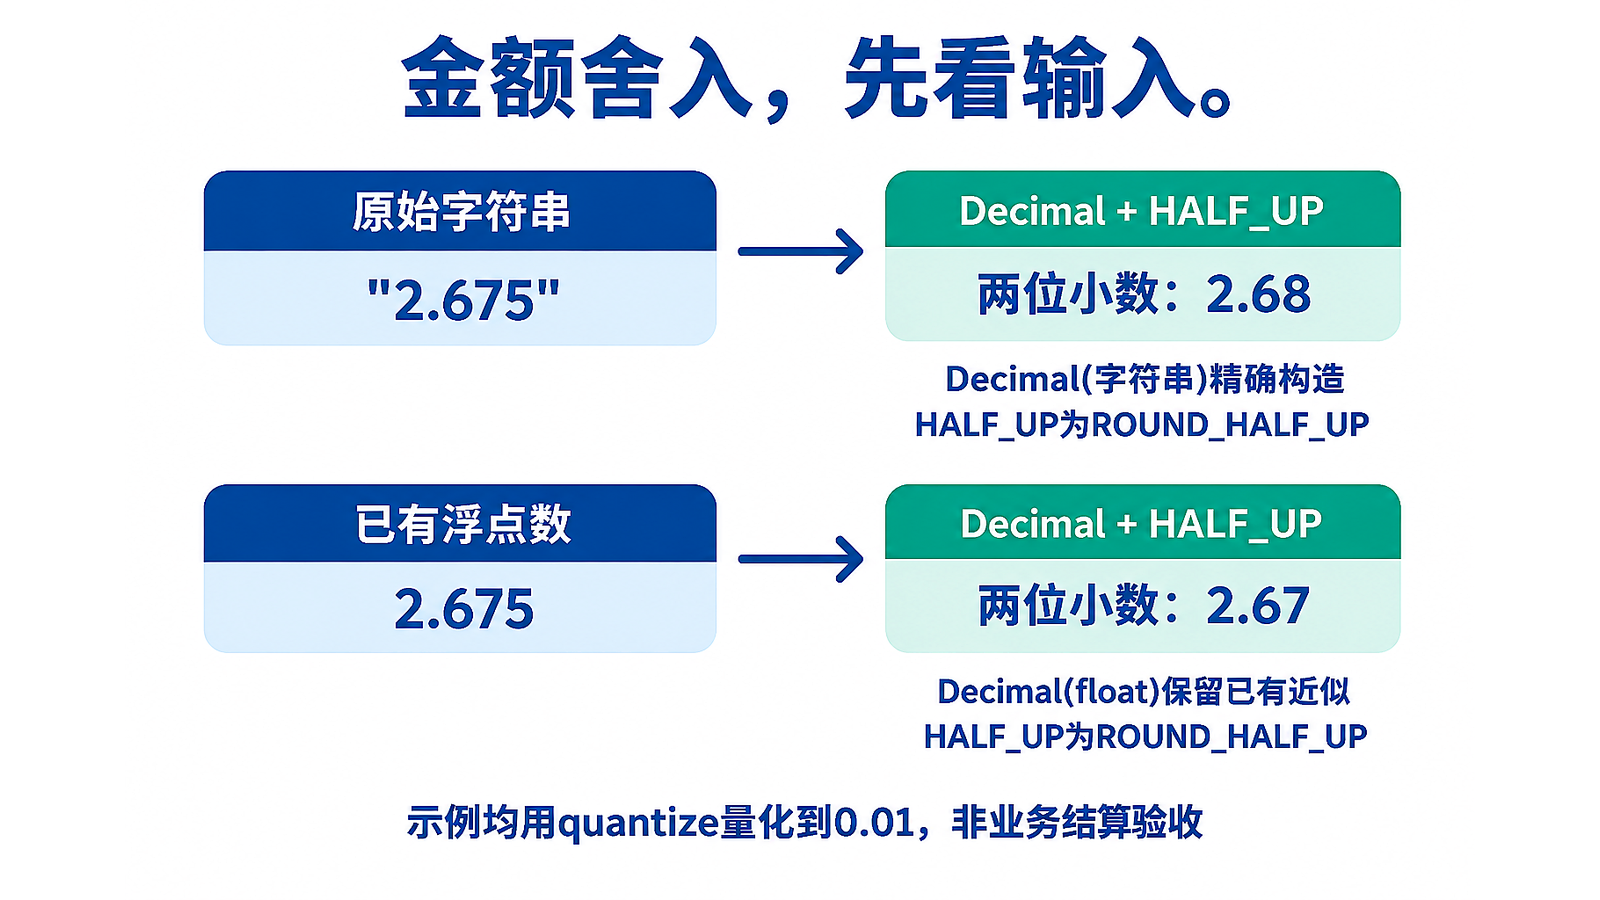
下面的入口函数只做教学需要的三件事:要求字符串、尝试十进制解析、拒绝非有限数。它会拒绝 NaN 和 Infinity,但并不是完整的业务金额校验器。是否接受负值、科学计数法、首尾空白,允许多长、多大,仍要另定规则。解析成功不等于这笔金额可以入账。
四、先写清中点规则,再调用quantize
ROUND_HALF_UP 是向最近值舍入,恰好中点时远离零,所以负的中点会向绝对值更大的方向走,并不是一律向正方向加。ROUND_HALF_EVEN 同样先找最近值,只在中点时选末位为偶数的一侧。别只用一个正数样例就决定采用哪种规则,正负中点和进位边界都值得放进测试。
quantize 采用第二个参数的指数。参数写成 0.01 是量化到两位小数,写成 0.05 也仍然是两位小数,不代表取五分的整数倍。实验中的 1.03 因此保持不变。若业务真要求某个步长,需要另行设计缩放、舍入与还原过程,并核对中间精度。
五、六组完整实验,可以直接复制运行
下面只有标准库依赖,保存成一个脚本即可运行。六组依次核对浮点近似、字符串入口与显示、正负中点、指数而非步长、构造与计算精度、舍入发生的位置。所有断言针对本组有限的小数值,不是可处理任意长度金额的通用工具。
from decimal import (Decimal as 十进制, localcontext as 局部上下文,
                     ROUND_HALF_UP as 半上, ROUND_HALF_EVEN as 半偶,
                     InvalidOperation as 无效运算)


def 金额(文本):
    # 教学入口:只收字符串,不代替业务格式与范围校验。
    if not isinstance(文本, str):
        raise TypeError('金额须为原始十进制字符串')
    try:
        数值 = 十进制(文本)
    except 无效运算 as 原因:
        raise ValueError('金额格式无效') from 原因
    if not 数值.is_finite():
        raise ValueError('金额须为有限数')
    return 数值


def 分位(数值):
    return 数值.quantize(十进制('0.01'), rounding=半上)


def 实验():
    with 局部上下文() as 上下文:
        上下文.prec = 28  # 仅覆盖本组小数值,不承诺任意精度。
        # 一:浮点近似不是十进制中点。
        近似 = 十进制(2.675)
        assert round(2.675, 2) == 2.67 and 近似 < 金额('2.675')
        print('一 浮点:', round(2.675, 2), '已有近似:', 近似)
        # 二:保留原字符串;显示不修改原对象。
        原值 = 金额('2.675')
        显示 = format(原值, '.2f')
        assert 分位(原值) == 金额('2.68') and 原值 == 金额('2.675')
        assert 显示 == '2.68'
        print('二 字符串:', 分位(原值), '显示:', 显示, '原值:', 原值)
        # 三:中点时,负数也要核对。
        向外 = [分位(金额(文本)) for 文本 in ('2.665', '-2.665')]
        到偶 = [金额(文本).quantize(金额('.01'), rounding=半偶)
                for 文本 in ('2.665', '-2.665')]
        assert 向外 == [金额('2.67'), 金额('-2.67')]
        assert 到偶 == [金额('2.66'), 金额('-2.66')]
        print('三 中点远离零:', *向外, '中点到偶数:', *到偶)
        # 四:量化指数,不是量化到五分倍数。
        结果 = 金额('1.03').quantize(金额('.05'), rounding=半上)
        assert 结果 == 金额('1.03') and 结果 % 金额('.05') != 0
        print('四 指数量化:', 结果, '并非五分倍数')
        # 五:构造保留输入,计算才受精度约束。
        with 局部上下文() as 小上下文:
            小上下文.prec = 6
            assert 十进制(2.675) == 近似
            商 = 金额('1') / 金额('7')
            assert 商 == 金额('0.142857')
        print('五 六位有效数字:', 商, '构造未截断')
        # 六:逐项舍入与合计后舍入是两种约定。
        项目 = [金额('.005'), 金额('.005')]
        逐项 = sum(map(分位, 项目), 金额('0'))
        最后 = 分位(sum(项目, 金额('0')))
        assert 逐项 == 金额('.02') and 最后 == 金额('.01')
        print('六 逐项:', 逐项, '最后:', 最后)


if __name__ == '__main__':
    实验()
本地执行得到的关键对照是:浮点结果为 2.67,字符串入口为 2.68;正负 2.665 按中点远离零得到 2.67 与 -2.67,按中点到偶数则为 2.66 与 -2.66。两笔半分逐项舍入得到两分,合计后舍入得到一分。这些结果说明约定不同会产生差额,不能据此判定其中一种永远正确。
六、对着故障表现查,不靠“多保留几位”碰运气
还要注意,localcontext 中的精度是计算使用的有效数字位数,不是“小数点后位数”。实验把精度设为六,七分之一就只留下六位有效数字;把精度设得很大,也不能让无限循环小数突然变成有限精确值。量化后的系数超过精度时,还可能触发无效运算,不能把异常吞掉当作零金额继续走。
| 表现 | 先查什么 | 处理方向 |
|---|---|---|
| 两位舍入少一分 | 入口是否先转了浮点 | 保留原始十进制字符串 |
| 负中点与预期相反 | 是否误解远离零 | 显式规则并测正负数 |
| 五分量化仍有三分 | 是否把指数当步长 | 另定步长算法 |
| 量化抛出异常 | 有效数字精度与数值范围 | 检查预算,不静默补零 |
| 显示正确但合计不同 | 原对象及舍入时点 | 核对完整计算链 |
格式化返回的是字符串,不会改写原对象;原值仍可带着更多小数参与后续计算。十进制数和浮点数混合加法则会抛出类型错误,应该统一输入链路,而不是临时把全部值强转成浮点来消除报错。
七、验收清单要覆盖输入、过程与边界
- 追溯原始输入,确认不是浮点运算后拼出的字符串;校验非有限数、非法文本和错误类型。
- 把舍入模式、适用范围和舍入发生的时点写进约定,覆盖正负中点、非中点与跨整数进位。
- 区分精度与小数位数,测试精度不足时如何失败,不承诺任意精确,也不让局部设置泄漏影响其他计算。
- 核对逐项与合计两条路径,明确差额如何处理;显示结果、数值对象与持久化值分别检查。
随文交付的是上面六组最小对照;另存的内部扩展脚本实际完成四十七项断言,覆盖输入拒绝、已有浮点误差、上下文恢复、混合类型等边界。扩展测试并没有全部塞进随文代码,不能把内部检查数量说成读者复制这段代码就执行的数量。
八、把结论收在这次实验的边界内
这次能确认的是标准库在本地内存对象上的表示、计算与舍入行为。没有连接支付接口,没有执行税务计算,也没有迁移账本或验证数据库字段。真实系统还要结合输入协议、存储精度、历史数据和业务结算约定验收;这里不给财税建议,也不建议靠批量重算覆盖旧数据来消除差异。
参考资料采用官方文档:构造与舍入语义以模块说明为准,二进制近似的背景看浮点教程。文档属于三点一四分支,本次执行器是三点一四点三,不把文档站当前维护版本冒称本机版本。
🔕 评论已关闭