一、文件有两条记录,为什么 load 只肯读一份
Python把两条记录连续写进同一个文件,再用json.load读取,常会报JSONDecodeError: Extra data。换个文件名或捕获异常都不算修好。下面用CPython 3.14.3的本地文件实验,分清单个JSON数组与JSON Lines两条路径,给多记录明确边界,并检查坏行是否真正被拒绝。
这种故障容易让人怀疑中文编码,其实应先看文件形状。两次dump各自都能输出合法对象,不代表拼起来还是一个合法JSON文档。官方文档提醒,JSON本身不是自动分帧的协议。就像两封信直接塞进一个信封,收件人需要知道哪里拆开,而不是猜第二封从哪个大括号开始。
二、Extra data说的是剩余内容,不是所有解析错误
json.load按一份JSON文档读取文件;json.loads按一份文档解析字符串。第一个值结束后,若后面还有非空白内容,就可能得到Extra data。本例连续写入两个对象,实测定位为第1行第10列,字符位置9;这些数字属于此样本,不是故障的固定坐标。
缺逗号、引号没闭合、字符串里出现未转义换行,都可能产生别的JSONDecodeError;字节不能按UTF-8解码,还可能先遇到UnicodeDecodeError。排查时保留异常类型、消息和位置,不要把所有输入错误都归成Extra data,更不要只删掉报错位置之后的数据。
三、先选文件契约:一个数组,还是逐行记录
如果数据本来就是一次交付的有限集合,把全部记录放进一个列表,调用一次dump,读取时调用一次load即可。JSON数组可以合法跨行排版,loads也能解析完整数组。它和JSON Lines是替代路径,不是先把数组写出来,再机械地按行拆开。
如果需要逐条顺序处理,可以约定JSON Lines:UTF-8编码、不带BOM,每个物理行是一个完整JSON值。对象和数组很常见,但null、false、数字、字符串也都是合法记录。若业务只接收字典,应另外验证类型,不能把业务限制说成格式要求。
| 输入或目标 | 选用方式 | 关键检查 |
|---|---|---|
| 一份完整记录集合 | 单JSON数组,load一次 | 整个文件只含一个值 |
| 多条逐行记录 | JSON Lines,逐行loads | 每行独立完整,无空行 |
| 同一行两个对象 | 拒绝,修正生产端 | 不能只读取第一个 |
| 跨行美化对象 | 单JSON可用,不能直接当JSONL | 先按原契约完整解析 |
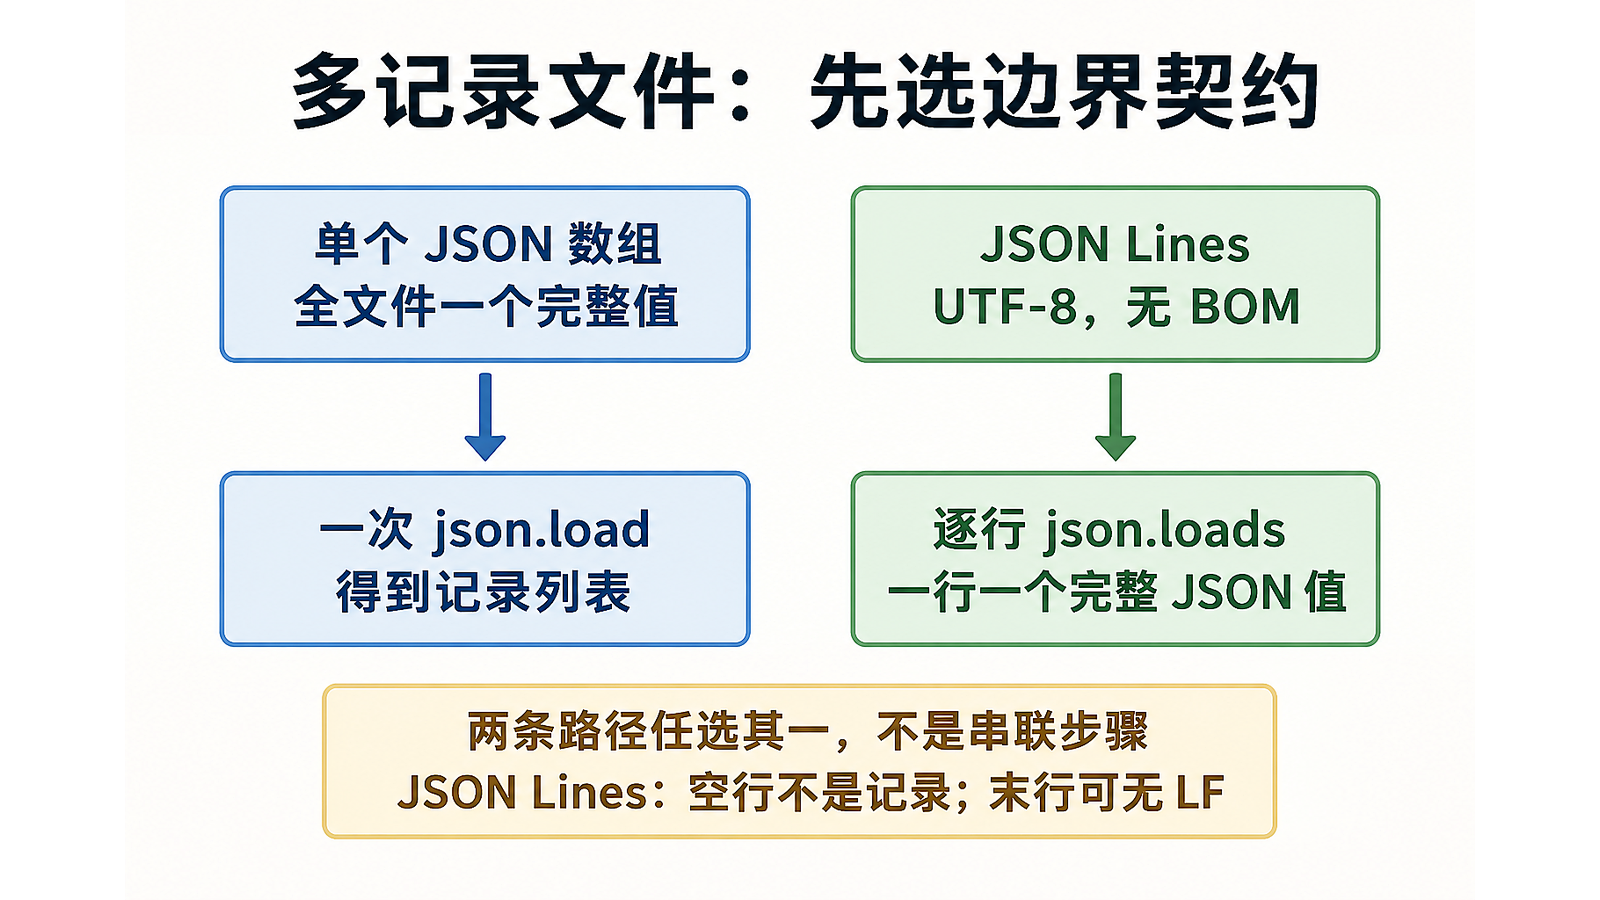
扩展名只是提醒,不会改变解析器行为。把两段对象拼接的文件从json改成jsonl,若记录仍挤在一行,逐行解析一样会失败。反过来,一个数组恰好占一行时,它在JSON Lines里是一条数组记录,不会自动展开成多条。这一点最好在接口约定里直接写明。
四、写入端负责边界,字符串换行不要手拆
写入时每条调用dumps,保持不设置indent,再追加一个换行符。ensure_ascii=False让中文直接可读,真正的文件编码仍由open的encoding决定。allow_nan=False负责拒绝写出的非有限浮点数;它不控制读取端,也不代替其他字段校验。
字符串里的真实换行会由序列化器编码成反斜杠加n,仍留在同一个物理行中。不要把字符串手工拼进JSON,也不要用正则或split('}{')抢救记录:文本值里可能恰好含有这两个字符,嵌套对象也会让这种猜法失效。
读入支持CRLF,也接受没有最后一个LF的末条记录;输出则统一每条补LF,方便后续拼接。末行换行是强烈建议,不是格式强制。空文件表示零条记录,只有一个换行符的文件却含空行,两者不能混为一谈。
五、完整标准库实验:保存后直接运行
把下面完整代码保存为example.py,执行python3 example.py即可。脚本按标准tempfile约定创建并清理临时目录,不依赖本文作者的机器路径,不读取生产日志,也不发网络请求。本文实际验收使用CPython 3.14.3,并由运行环境把临时目录限定在独立scratch内。
读取逐行文件按LF划分记录,主动拒绝空行,解析失败加上文件行号并保留原异常链,不用continue假装成功。读取端另外拒绝NaN和Infinity字面量,并把浮点溢出列为示例输入策略;合法JSON数字1e400也会因此被拒绝,这不是JSON Lines本身禁止该数字。
import json
import math
import sys
import tempfile
from pathlib import Path


def 拒绝特殊数值(文本):
    raise ValueError(f"非标准数值字面量: {文本}")


def 读取有限浮点(文本):
    值 = float(文本)
    if not math.isfinite(值):
        raise ValueError("number exceeds this reader's finite-float policy")
    return 值


def 写入逐行文件(路径, 数据集):
    # 覆盖目标,仅供实验,不是原子发布函数。
    with open(路径, "w", encoding="utf-8", newline="\n") as 文件:
        for 值 in 数据集:
            行 = json.dumps(值, ensure_ascii=False, allow_nan=False)
            文件.write(行 + "\n")


def 读取逐行文件(路径):
    # 仅LF切分记录;CRLF中的回车是合法JSON空白。
    with open(路径, "r", encoding="utf-8", newline="\n") as 文件:
        for 行号, 行 in enumerate(文件, 1):
            if not 行.strip():
                raise ValueError(f"line {行号}: blank line is not a record")
            try:
                值 = json.loads(行, parse_constant=拒绝特殊数值,
                                   parse_float=读取有限浮点)
            except ValueError as 错误:
                raise ValueError(f"line {行号}: {错误}") from 错误
            yield 值


def 自检():
    检查列表 = []

    def 检查(名称, 条件):
        if not 条件:
            raise RuntimeError(f"检查失败: {名称}")
        检查列表.append(名称)

    def 预期异常(名称, 异常类型, 动作, 片段=""):
        try:
            动作()
        except 异常类型 as 错误:
            检查(名称, 片段 in str(错误))
            return 错误
        raise RuntimeError(f"检查失败: {名称}: no expected exception")

    # 临时目录由运行环境的标准约定决定,退出后清理。
    with tempfile.TemporaryDirectory(prefix="jsonl-") as 目录:
        根路径 = Path(目录)
        路径 = 根路径 / "records.jsonl"
        反例路径 = 根路径 / "multiple.json"
        with open(反例路径, "w", encoding="utf-8") as 文件:
            json.dump({"id": 1}, 文件)
            json.dump({"id": 2}, 文件)
        def 读取反例():
            with open(反例路径, encoding="utf-8") as 文件:
                return json.load(文件)
        错误 = 预期异常("repeated_dump_extra_data", json.JSONDecodeError,
                       读取反例, "Extra data")
        诊断 = {"msg": 错误.msg, "line": 错误.lineno,
                      "column": 错误.colno, "position": 错误.pos}

        数组路径 = 根路径 / "array.json"
        with open(数组路径, "w", encoding="utf-8") as 文件:
            json.dump([{"id": 1}, {"id": 2}], 文件)
        with open(数组路径, encoding="utf-8") as 文件:
            检查("single_array_load", json.load(文件) == [{"id": 1}, {"id": 2}])

        数据集 = [{"note": "第一行\n第二行", "literal": "}{"},
                  None, False, 0, 12.5, "文本", [1, 2]]
        写入逐行文件(路径, 数据集)
        字节内容 = 路径.read_bytes()
        检查("all_value_types_roundtrip", list(读取逐行文件(路径)) == 数据集)
        检查("utf8_without_bom", "第一行".encode("utf-8") in 字节内容
              and not 字节内容.startswith(b"\xef\xbb\xbf"))
        检查("one_lf_per_record", 字节内容.count(b"\n") == len(数据集)
              and 字节内容.endswith(b"\n") and b"\r\n" not in 字节内容)
        检查("string_newline_is_escaped", b"\\n" in 字节内容)

        def 读取字节(字节内容):
            路径.write_bytes(字节内容)
            return list(读取逐行文件(路径))

        检查("crlf", 读取字节(b"null\r\nfalse\r\n") == [None, False])
        检查("last_record_without_lf", 读取字节(b"0\nfalse") == [0, False])
        检查("surrounding_json_whitespace", 读取字节(b"  0 \t\n") == [0])
        检查("empty_file_has_no_records", 读取字节(b"") == [])
        invalid = [
            ("blank_line", b"\n", "line 1"),
            ("whitespace_line", b" \t\r\n", "blank line"),
            ("two_values_on_one_line", b"{} {}\n", "Extra data"),
            ("pretty_multiline_object", b'{\n  "id": 1\n}\n', "line 1"),
            ("broken_json", b'{"id":}\n', "line 1"),
            ("initial_bom", b"\xef\xbb\xbf{}\n", "BOM"),
            ("raw_newline_in_string", b'"a\nb"\n', "line 1"),
            ("nan_literal", b"NaN\n", "非标准数值字面量"),
            ("infinity_literal", b"Infinity\n", "非标准数值字面量"),
            ("negative_infinity_literal", b"-Infinity\n", "非标准数值字面量"),
            ("finite_float_policy", b"1e400\n", "finite-float policy"),
        ]
        for 名称, 字节内容, 消息 in invalid:
            预期异常(名称, ValueError, lambda 字节内容=字节内容: 读取字节(字节内容), 消息)
        预期异常("invalid_utf8", UnicodeDecodeError,
               lambda: 读取字节(b'"\xff"\n'))
        检查("duplicate_names_not_rejected",
              读取字节(b'{"x":1,"x":2}\n') == [{"x": 2}])

        路径.write_bytes(b'{"id":1}\nnot-json\n{"id":3}\n')
        迭代器 = 读取逐行文件(路径)
        已交付 = [next(迭代器)]
        预期异常("middle_error_propagates", ValueError,
               lambda: next(迭代器), "line 2")
        检查("delivered_record_not_rolled_back", 已交付 == [{"id": 1}])
        预期异常("list_also_fails", ValueError,
               lambda: list(读取逐行文件(路径)), "line 2")

        for 名称, 值 in [("write_nan", float("nan")),
                            ("write_infinity", float("inf")),
                            ("write_negative_infinity", float("-inf"))]:
            预期异常(名称, ValueError, lambda 值=值: 写入逐行文件(路径, [0, 值]))
        检查("writer_failure_keeps_partial_file", 路径.read_bytes() == b"0\n")
    检查("temporary_files_cleaned", not 根路径.exists())
    print(json.dumps({"python": sys.version.split()[0],
                      "implementation": sys.implementation.name,
                      "executable": sys.executable,
                      "passed": len(检查列表), "tests": 检查列表,
                      "extra_data_diagnostic": 诊断,
                      "scope": "ordinary temporary local files; no network or concurrency"},
                     ensure_ascii=False, indent=2))


if __name__ == "__main__":
    自检()
六、坏行在中间,前面交出去的数据不会撤回
逐行生成器不是事务。第一条yield给调用者后,第二条才发现错误,第一条已经发生的业务写入不会回滚。本实验先取出首条,再触发第二行错误,核对先前记录仍在列表中;不能据此推断数据库、队列或真实服务的回滚行为。
有限且能装入内存的输入,可以先用list完整读取,通过后再启动后续业务处理。但它会消耗整个输入,不能撤销读取动作或解析钩子的副作用,也不适合无界流。不要在异常处理里吞掉坏行,最后只打印“处理完成”,那只是把失败藏起来了。
写入函数也有边界:它使用w模式覆盖目标,第二条无法序列化时,第一条可能已经写入,旧文件也已被截断。因此它只适合作为最小实验;需要保留旧文件、原子替换或恢复方案时,应另行设计,不能直接拿它覆盖重要资料。
错误定位只辅助排查,不负责自动修补。对于一行一个值的文件,先定位文件行号,再查看该行的解析列号;不要把整条生产记录直接抄进告警,里面可能有个人信息。本文只用人工构造的数据,既保留失败信息,也避免把真实日志带进实验。
七、自检结果与没有解决的问题
这份随文脚本实测通过31项检查,覆盖重复dump故障、数组对照、各类JSON值往返、换行与编码、坏行拒绝、部分交付及写入失败残留。检查采用显式函数和异常,不把必要动作放进assert;即使启用优化,也不会因此删掉这些动作。
默认json还会接受重复键,示例明确保留这一行为;数值精度、字段范围与业务schema也没有完整处理。拒绝非有限数不等于通用安全解析器。逐行读取没有设置单行字节上限,一条超长记录仍可能占用大量内存,受限输入要在更外层限制资源。
追加模式、多进程协作、写入交错、断电耐久性以及半条尾记录,都不在这次测试范围内。每条末尾有LF不等于一次写入具有原子性;文件close成功也不能替代持久化保证。这里只证明普通本地文件上的格式与异常路径,不能冒充生产日志验收。
验收时还要对照记录数量和记录内容,不能只看退出码。比如合法的false在Python里是假值,null对应None,若用“值为真才保留”的条件过滤,它们会被误删。这里的往返测试把这些值一并保留,证明读端没有把假值当成缺失记录。
八、交付前的检查清单
- 生产端与消费端选择同一契约:完整数组或JSON Lines。
- 显式UTF-8,无BOM;每行完整,空行拒绝。
- 中文、字符串换行、CRLF和末行无LF均有样本。
- 同一行多值、跨行对象和非法字节会失败,而非静默遗漏。
- 明确部分交付不回滚,另验业务字段、资源及并发边界。
我更愿意先修生产端,再考虑兼容旧文件。把边界约定写清楚,读端就不用当侦探。若旧文件其实是一份完整数组,继续用load;若确实是逐条记录,就让每行完整,并把失败报告给调用方,而不是靠跳过错误把数量凑齐。
参考资料:Python 3.14 json文档(单文档与分帧说明、序列化和解析参数);JSON Lines格式说明(编码、值类型、行终止符)。本次文档页面标注3.14.10,实际实验解释器为3.14.3;这里只核对上述行为,不据此宣称最低版本。
🔕 评论已关闭