一、列数突然变多,先检查记录边界
读取三列CSV,备注一带逗号就变四列,带换行又被拆成两条记录,通常不是数据凭空损坏,而是读取方式错了。本文在Linux的CPython 3.14.3上用临时文件实测,给出完整标准库脚本,处理引号、逗号、跨行字段,并把格式解析与业务校验分开。
先看失败代码的思路:逐行读取,再调用split(',')。这只认识字符,不认识CSV的引用规则。备注“甲,乙”即使已用双引号包围,逗号仍会被切开;把readlines得到的每行当成独立记录,同样无法处理字段内部的回车换行。事后补齐或截断列数,只会把错位藏起来。
本文不重做编码迁移,而是定位“字节能读出来,列却对不上”的故障。排查时保留原文件,先确认交付的编码、分隔符与表头,再决定解析参数;不要为了让程序继续跑,就悄悄丢弃异常字段。
二、逗号、双引号和换行都可能属于字段
CSV并不是“逗号分隔的每一行文本”这么简单。常见逗号方言中,字段内的逗号放进双引号,字段内的双引号写成两个连续双引号,字段本身还可以包含CRLF。解析器必须记住当前是否处于引用字段中,才能判断眼前的逗号或换行是不是分界。
例如脚本生成的备注包含“他说”与一个带引号的“好”,文件里会出现成对重复的双引号,读出来则恢复成一个双引号。跨行备注也只属于一条逻辑记录,而不是两条待拼接的坏记录。不要先对每行strip,再尝试用正则补救,字段本来合法的空白也可能被改掉。
RFC 4180第二节描述了这类引用约定,但它是信息性文档,不代表所有交付文件都使用同一种方言。分号文件就应显式传delimiter=';';自动猜测可以辅助调查,不能替代双方确认的交付约定。
三、打开文件时,把换行和编码说清楚
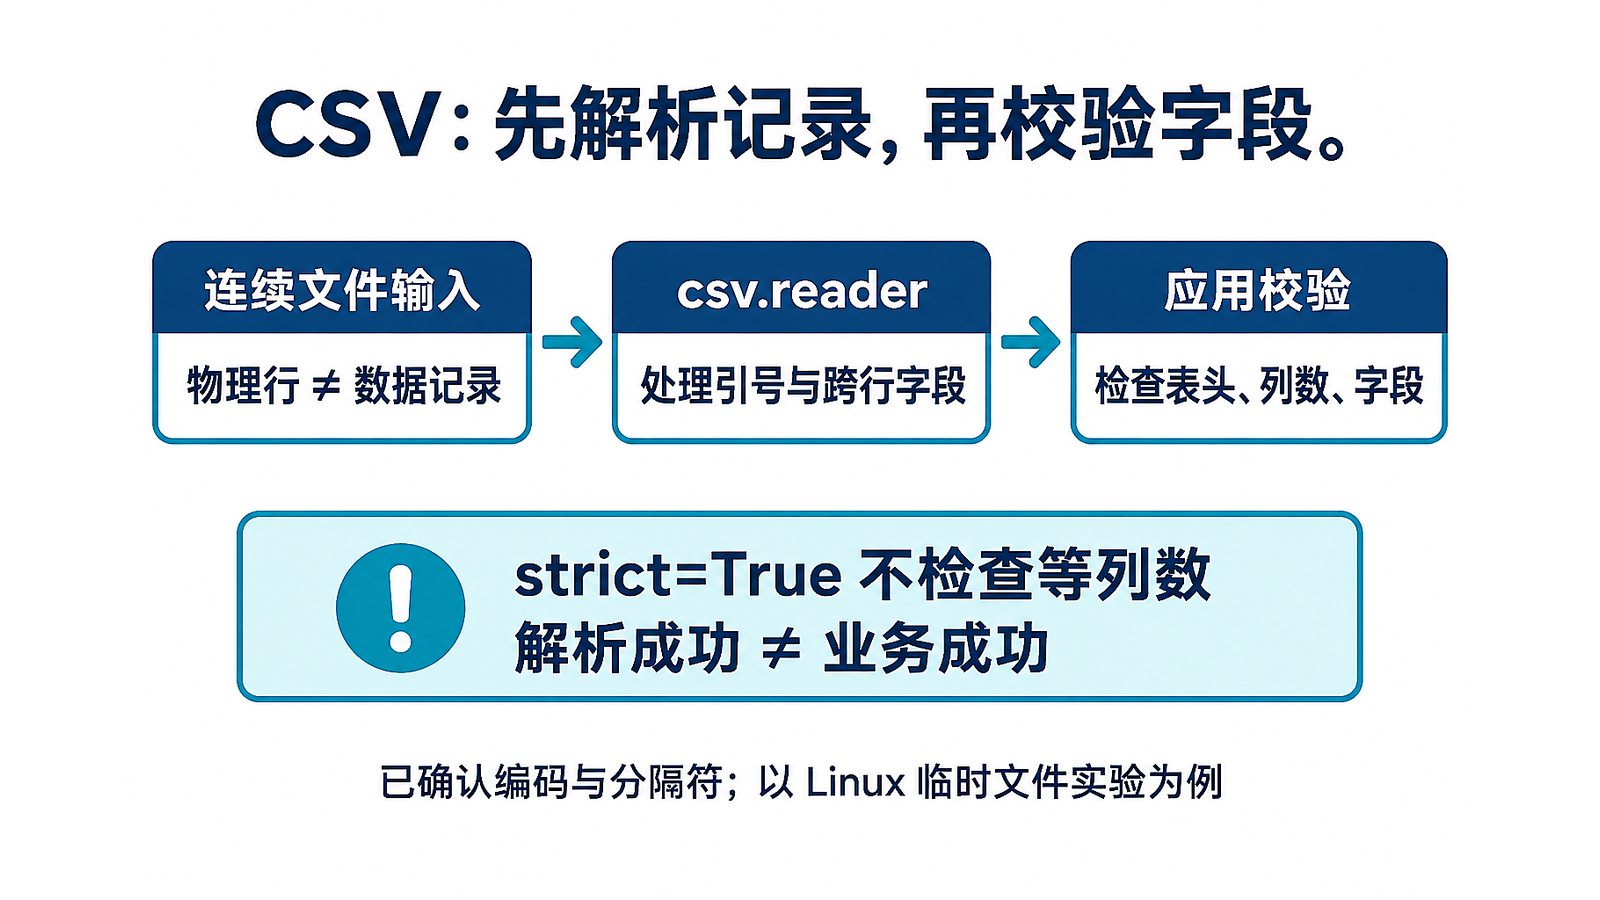
读取CSV文件时显式设置newline='',让文本层保留换行形式,由csv模块处理记录边界。实验中的引号字段含有真正的CRLF,按这个方式读取后仍保留CRLF;改用默认newline=None,文本层会把它归一成LF。能解析出三列,并不等于字段内容没有发生变化。
这里已知样本按UTF-8交付,所以使用encoding='utf-8-sig',兼容文件开头有或没有UTF-8签名。普通utf-8解码不会自动去掉这个签名,首列表头可能变成带不可见字符的“编号”。这个选项不是万能编码探测器,更不表示任意本地编码文件都能读取。
解码仍保持errors='strict'。非法UTF-8会抛出UnicodeDecodeError,应停止并向交付方确认,而不是改成ignore或replace后继续校验列数。编码失败、CSV引用错误和业务字段错误是三层问题,错误处理也应分别记录,不能合并成一句“文件格式不对”。
四、strict管解析,不替你决定数据结构
strict=True可让本例未闭合的引用字段抛出csv.Error,却不会要求每条记录的字段数相等。实测同一个严格解析器照样返回两列、一列、三列的记录。因此需要先核对精确表头,再逐条检查列数,最后才判断编号和数量是否符合业务要求。
下面固定三列表头及顺序为“编号、数量、备注”,编号要求四位ASCII数字,数量要求非空的非负ASCII整数文本,备注不另设内容限制。空文件或空白表头拒绝,数据区空记录拒绝,仅有正确表头则接受为零条数据。这是教学输入约定,不是通用CSV规则或完整schema。
默认读取模式返回字符串,0007与02不会自动变成整数,编号的前导零因此保留下来。数量需要计算时,应在独立业务步骤转换并补充范围限制。不要为了方便打开自动数值转换选项,让编号先丢失表示信息,再指望后面补回来。
换成DictReader也不能省去校验:额外字段默认收进键None对应的列表,缺失字段默认填None;重复表头映射成字典后,早先同名列的值可能被覆盖。先用reader检查精确表头和列数,能避免把这些容错行为误当成合法数据。
五、完整实验:保存为example.py直接运行
脚本只依赖标准库,自建临时目录和虚构样本,结束后清理,不访问数据库或发布接口。保存为example.py后运行python3 example.py,可得到逐项JSON结果;也可分别运行优化模式。所有门禁使用显式异常,不依赖会被优化移除的assert。
import csv
import json
import platform
from pathlib import Path
from tempfile import TemporaryDirectory

表头 = ["编号", "数量", "备注"]


def 读取(路径, 分隔符=",", 读取日志=None):
    # 固定教学约定:已确认 UTF-8;空记录拒绝;编号四位,数量为非负 ASCII 整数。
    with open(路径, encoding="utf-8-sig", errors="strict", newline="") as 文件:
        def 物理行():
            for 行 in 文件:
                if 读取日志 is not None:
                    读取日志.append("已读物理行")
                yield 行
        解析器 = csv.reader(物理行(), delimiter=分隔符, strict=True)
        if next(解析器, None) != 表头:
            raise ValueError("表头缺失、重复或不匹配")
        for 记录号, 行 in enumerate(解析器, 1):
            位置 = f"数据记录{记录号},累计物理行{解析器.line_num}"
            if len(行) != len(表头):
                raise ValueError(f"{位置}:列数应为3,实际{len(行)}")
            编号, 数量, 备注 = 行
            if len(编号) != 4 or not all("0" <= 字 <= "9" for 字 in 编号):
                raise ValueError(f"{位置}:编号必须为四位ASCII数字")
            if not 数量 or not all("0" <= 字 <= "9" for 字 in 数量):
                raise ValueError(f"{位置}:数量必须为非负ASCII整数文本")
            yield 行  # 保留字符串;需要计算时另做受控转换。


def 实验():
    结果 = []
    with TemporaryDirectory(prefix="csv-reader-") as 目录:
        路径 = Path(目录) / "样本.csv"
        标题 = ",".join(表头) + "\r\n"
        正常 = 标题 + "0007,02,正常\r\n"

        def 写入(内容):
            路径.write_bytes(内容 if isinstance(内容, bytes) else 内容.encode("utf-8"))

        def 核验(名称, 动作, 预期=None, 异常=None):
            try:
                实际 = 动作()
            except Exception as 错误:
                if 异常 is None or not isinstance(错误, 异常):
                    raise
                结果.append({"名称": 名称, "通过": True, "异常": type(错误).__name__, "信息": str(错误)})
            else:
                if 异常 is not None or 实际 != 预期:
                    raise RuntimeError(f"{名称}失败:{实际!r},预期{预期!r}")
                结果.append({"名称": 名称, "通过": True, "实际": 实际})

        def 文件用例(名称, 内容, 预期=None, 异常=None, 分隔符=","):
            写入(内容)
            核验(名称, lambda: list(读取(路径, 分隔符)), 预期, 异常)

        def 原始(换行="", 编码="utf-8-sig", 严格=True):
            with open(路径, encoding=编码, newline=换行) as 文件:
                解析器 = csv.reader(文件, strict=严格)
                return [[行, 解析器.line_num] for 行 in 解析器]

        文件用例("字段逗号", 标题 + '0007,02,"甲,乙"\r\n', [["0007", "02", "甲,乙"]])
        文件用例("内嵌双引号", 标题 + '0007,02,"他说""好"""\r\n', [["0007", "02", '他说"好"']])
        写入(标题 + '0007,02,"上\r\n下"\r\n')
        核验("CRLF跨行与物理行号", 原始, [[表头, 1], [["0007", "02", "上\r\n下"], 3]])
        核验("主读取保留CRLF", lambda: list(读取(路径)), [["0007", "02", "上\r\n下"]])
        核验("默认换行转换对照", lambda: 原始(None)[1][0][2], "上\n下")
        文件用例("无BOM保留字符串前导零", 正常, [["0007", "02", "正常"]])
        文件用例("有BOM", b"\xef\xbb\xbf" + 正常.encode("utf-8"), [["0007", "02", "正常"]])
        核验("utf8不剥离BOM", lambda: 原始(编码="utf-8")[0][0][0], "\ufeff编号")
        文件用例("分号显式指定", "编号;数量;备注\r\n0007;02;正常\r\n", [["0007", "02", "正常"]], 分隔符=";")
        核验("分号误用逗号拒绝", lambda: list(读取(路径)), 异常=ValueError)
        for 名称, 内容 in [("空文件", ""), ("只有空行", "\r\n"), ("缺列", 标题 + "0007,02\r\n"), ("多列", 标题 + "0007,02,甲,乙\r\n"), ("错表头", "编号,数额,备注\r\n"), ("重复表头", "编号,编号,备注\r\n"), ("中间空行", 标题 + "\r\n"), ("坏编号", 标题 + "7,02,甲\r\n"), ("坏数量", 标题 + "0007,-1,甲\r\n")]:
            文件用例(名称, 内容, 异常=ValueError)
        文件用例("未闭合引号", 标题 + '0007,02,"未闭合\r\n', 异常=csv.Error)
        文件用例("非法UTF8", 标题.encode("utf-8") + b"0007,02,\xff\r\n", 异常=UnicodeDecodeError)
        文件用例("仅表头零数据", 标题, [])
        写入('\r\n""\r\n,,\r\n')
        核验("默认reader不跳空行", lambda: 原始(严格=False), [[[], 1], [[""], 2], [["", "", ""], 3]])
        写入("甲,乙\r\n丙\r\n丁,戊,己\r\n")
        核验("strict不检查等列数", lambda: [len(项[0]) for 项 in 原始()], [2, 1, 3])
        写入("001,2.5\r\n")
        核验("默认不转数值", lambda: 原始()[0][0], ["001", "2.5"])
        def 流式失败():
            写入(正常 + "0008,1\r\n")
            日志, 业务 = [], []
            迭代器 = 读取(路径, 读取日志=日志)
            创建时 = len(日志)
            业务.append(next(迭代器))
            前缀时 = len(日志)
            try:
                list(迭代器)
            except ValueError:
                return [创建时, 前缀时, len(日志), 业务]
            finally:
                迭代器.close()
            raise RuntimeError("未拒绝后续坏记录")
        核验("生成器部分读取与业务不回滚", 流式失败, [0, 2, 3, [["0007", "02", "正常"]]])

        def 先完整读取():
            写入(正常 + "0008,1\r\n")
            日志, 业务, 候选 = [], ["已有业务"], ["原候选"]
            try:
                候选 = list(读取(路径, 读取日志=日志))
                业务.extend(候选)
            except ValueError:
                return [len(日志), 业务, 候选]
            raise RuntimeError("未拒绝后续坏记录")
        核验("list失败不撤销读取且不调用后续业务", 先完整读取, [3, ["已有业务"], ["原候选"]])
    print(json.dumps({"解释器": platform.python_implementation(), "版本": platform.python_version(), "用例数": len(结果), "结果": 结果}, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    实验()
六、读懂结果:空行和行号不要猜
最终脚本包含二十七个验收用例,默认、单层优化和双层优化均实际执行通过;从本文HTML提取的同一代码也分别重放。重复运行用于核对一致性,不计成新增用例。测试对象是Linux生成的普通文件,不是实际Excel导入、Windows系统或生产数据验收。
原始reader遇到空白物理行,实测返回空列表,并非自动跳过。只含一对双引号的记录返回一个空字符串,两个逗号则返回三个空字符串,三者不能混为一谈。本实现对数据区的空列表按列数错误拒绝,没有暗中启用跳过策略。
本例表头占一条物理行,下一条数据的备注横跨两行;返回该数据后line_num为三。它统计已经从输入迭代器读取的行数,不是业务记录编号。代码另用enumerate从一计数数据记录,诊断同时给出两者;这里空记录也进入枚举后再被拒绝。
七、生成器读到一半,不等于全文件合格
调用读取函数只创建生成器,尚未打开并遍历文件;第一次取值才开始校验。第一条数据合法时可以先返回,第二条缺列要继续迭代才报错。实验故意在第一条后追加一项模拟业务记录,后续失败时,这项记录仍在,解析器不会替调用方撤销它。
有限且能装进内存预算的输入,可以先list完整收集,确认全部检查通过后再调用后续业务。实验中收集失败时,右侧没有成功返回,所以候选变量保留旧值,后续追加没有执行;但三条物理行已被读取,读取日志照样存在。这个边界不是事务,也不保证任何并发语义。
大文件不能无预算地全部装入内存;需要另行设计分批验证、暂存和提交策略。提前停止消费生成器时也要显式close,或通过合适的上下文管理安排关闭,避免把文件生命周期寄托于垃圾回收。文件读完、数据合格和业务写入成功应分别验收。
八、按故障分层排查,再交付验收
先比较交付约定和解析参数,再对照下面的故障表定位,不要看见列数不符就删除逗号或空行。还要留意,默认writer把None写成空字符串是不可逆转换;后续reader不能凭空恢复原本的空值语义,这一点来自官方文档,不属于本脚本的恢复能力。
| 现象 | 优先检查 | 处理方向 |
|---|---|---|
| 带逗号后列数增加 | 是否使用split | 让reader处理引用 |
| 一条备注变成两条记录 | 是否按物理行独立解析 | 把连续文件迭代器交给reader |
| 首列表头肉眼相同却失败 | UTF-8签名与精确表头 | 确认编码后选择utf-8-sig |
| strict下仍有多列或缺列 | 应用是否检查len | 精确列数与字段规则分开验证 |
| 提示unexpected end of data | 引用字段是否闭合 | 保留原文件,修正交付数据 |
| 非法字节解码失败 | 交付编码是否确认 | 停止;不要忽略字节继续导入 |
- 确认编码与分隔符,保留原始字节,不盲猜方言。
- 引号内逗号、双引号与CRLF往返内容正确,编号保留前导零。
- 空文件、空记录、错表头、重复表头、缺列和多列按约定处理。
- 区分物理行号、数据记录号,异常不得吞掉后继续入库。
- 完整消费才完成全量校验;预算、资源关闭和业务提交另行设计。
把格式解析、结构校验和业务提交拆开,故障就有了明确落点:该修交付数据时不放宽解码,该修读取方式时不篡改字段,该补业务校验时也不把责任交给strict。
🔕 评论已关闭