1. 百分号没写错,读它的规则可能选错了
INI 里写着 bad = 80%,文件看起来很普通,Python 却在取值时抛出 InterpolationSyntaxError。先别删除百分号,也别急着把整个文件里的百分号都加倍。configparser 默认会把值当作支持插值的字符串处理;对它来说,百分号可能是引用的开头,不一定只是一个符号。
本文用 Python 3.14.3 做隔离实验,只在临时目录写入自造的 INI,不读取业务配置,不访问网络,也不修改生产文件。要解决的是“配置中的内容应该怎样解释”,而不是让异常暂时消失。尤其是百分号编码的文本、进度提示和模板字符串,原样保存与展开引用可能是两种完全不同的需求。
2. 为什么 read_string 成功,get 还能失败
默认的 ConfigParser 使用 BasicInterpolation。它认识 %(root)s 这样的引用,也认识代表字面百分号的 %%;孤立的 %、% 后接普通字符,或者不完整的引用,都可能在展开时触发语法错误。这里不是 Python 正在执行字符串格式化表达式,而是解析器自己的插值逻辑在处理配置值。
关键在于处理时机:read_string 和 read_file 可以先把带坏百分号的值读进去,普通 get 才按需展开。加载完成只能证明这一步没有遇到相应读取错误,不能替代逐项取值验证。实验分别覆盖字符串读取和真实文件读取,避免把“内存示例跑通”当作磁盘配置已经测过。
还有一个容易混淆的入口:默认插值模式下,通过 set 写入坏百分号可能当场得到 ValueError,因为写入入口也做插值语法检查。因此,本文关于延迟报错的结论限定在示例中的读取路径,不推广成“所有赋值都等到 get 才检查”。
3. 先决定要字面值,还是要引用展开
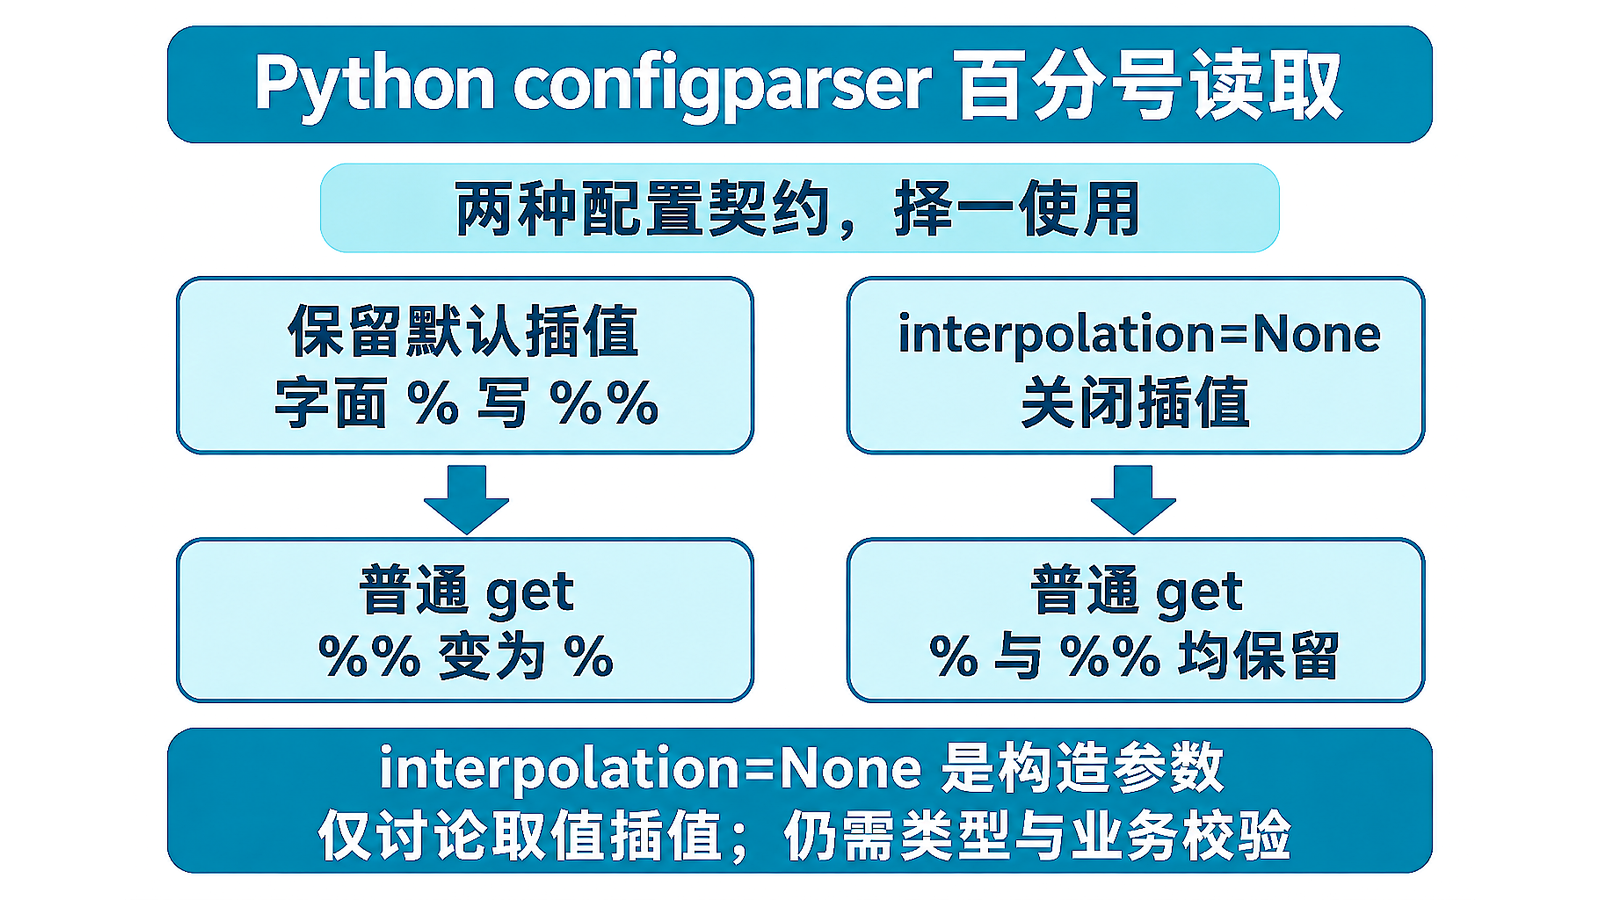
如果这份 INI 的约定就是保存普通文本,在创建对象时明确传入 interpolation=None。这样既不会展开 %(root)s,也不会把 %% 还原成单个 %。它不是只放宽某一个字符,而是关闭了这份解析器的插值处理;原先依赖引用拼接的目录、文件名或提示语,也会跟着保留为占位文本。
如果配置确实要复用变量,就保留默认插值,把字面百分号写为 %%。例如 escaped = 80%%,普通 get 得到 80%;path = %(root)s/logs 则继续展开引用。不要对全文件盲目替换:把已经正确的 %% 再加倍,会改变输出;把合法引用的百分号也替换掉,又会让引用失效。
只有本次读取要查看原始字符串时,用 get 的 raw=True 参数。它跳过这一次取值的插值,不会永久更改对象,也不会把磁盘文件改写。下一次不带 raw=True 的 get 仍然可能报错。这里的“原始”指跳过插值,不是保留文件的每一个字节;INI 解析仍然有自己的格式和空白处理。
4. 把失败现象和处理方式分开
看异常类型比只搜“百分号报错”更有用。引用语法本身不合法、引用目标不存在,以及循环引用耗尽插值深度,是不同的问题。raw=True 能帮助查看待展开内容,却不能证明这些引用在业务上合理;也不要把所有异常统一吞掉后返回空串,那会把配置缺陷拖到更远的调用点。
下面的表格给出默认行为与处理方向,而不是自动修复脚本。先确认配置作者的意图,再决定修改读取策略还是修改具体值。检查日志时只记录必要的节名、选项名和错误类型;真实配置可能含敏感内容,不应为了排错把整份配置或者完整异常上下文直接发到公共渠道。
| 现象 | 默认结果 | 检查方向 |
|---|---|---|
| 80% 或坏引用语法 | InterpolationSyntaxError | 字面值选 None;保留插值时只转义字面 % |
| %(absent)s | InterpolationMissingOptionError | 补齐正确引用,不用 fallback 掩盖 |
| %(loop)s 自引用 | InterpolationDepthError | 排查循环或过长引用链 |
| DEFAULT 中有 workers | 取 DEFAULT 而非 fallback | 核对默认项来源 |
| 已有值 four / perhaps | 类型转换 ValueError | 纠正输入并保留失败门禁 |
| Extended 的 $80 | InterpolationSyntaxError | 字面美元用 $$,不能套用 %% 规则 |
5. fallback 不是异常消音器,布尔值也别偷懒
配置中有 DEFAULT 时,某个节没有直接定义的选项,仍可能从 DEFAULT 取到。示例把 workers 放在 DEFAULT 中,getint 即使指定 fallback=9,也会得到默认项的 4。对存在的节来说,不能看到“当前节没有这行”就推断一定会用 fallback;要把默认项一起纳入排查。
fallback 主要解决请求的节或选项缺失,不负责掩盖已存在值的插值错误和类型转换失败。bad = 80% 不会因为附上 fallback 就变成备用字符串;badint = four 也不会因提供备用整数而合法。缺失值可以按约定兜底,格式错误则应明确拒绝,两条处理路径不要揉在一起。
布尔值请用 getboolean。非空字符串 false 传给 bool,结果仍是真;那是在检查字符串是否为空,不是在读配置开关。getboolean 默认识别 true/false、yes/no、on/off 和 1/0,且不区分大小写。像 perhaps 这样的值会抛出 ValueError,示例特意保留这个失败分支。
6. ExtendedInterpolation 换的是语法,不是万能兼容层
ExtendedInterpolation 使用 ${option} 和 ${section:option} 表示引用,字面美元符号写成 $$。它不沿用 BasicInterpolation 的百分号语法:普通 % 可以原样读取,而 %(root)s 也不会自动按旧规则展开。把处理器换掉虽然可能让百分号报错消失,却可能悄悄留下原来需要替换的占位符。
所以迁移插值策略要同时检查正例和反例。下面既测试跨节引用和 $$ 的结果,也测试孤立美元符号的异常,并确认旧百分号引用仍是原文。关闭插值或改用扩展插值,都不是自动安全修复,更不能替代业务验收;只看进程有没有抛异常,容易把错误输出当成修好了。
7. 完整实验:写临时 INI,再逐项核对
把下面代码保存为 example.py,用目标 Python 解释器运行即可;全部依赖来自标准库。临时文件位置遵循标准库 tempfile 的约定;运行时可通过 TMPDIR 指定隔离目录。测试结束会清理临时 INI,仅向标准输出写 JSON;需要留证时,由调用方保存标准输出,不会覆盖现有业务文件。
每次检查 都记录实际返回值或异常类型,并核对预期。预期失败的用例只有得到指定异常才算通过,意外成功同样会导致整体失败。最终用结果列表聚合总数,并在存在失败时非零退出,没有把 assert 当验收开关,因此优化模式不会把这些检查整句删掉。
import configparser as 配置解析
import json
import os
import sys
import tempfile
from pathlib import Path

默认配置 = """[DEFAULT]
workers = 4
root = data
[app]
bad = 80%
escaped = 80%%
missing = %(absent)s
loop = %(loop)s
path = %(root)s/logs
enabled = false
badbool = perhaps
badint = four
"""
扩展配置 = """[base]
root = data
[app]
path = ${base:root}/logs
price = $$80
bad = $80
percent = 80%
old = %(root)s/logs
"""


def 主流程():
    结果 = []

    def 检查(名称, 动作, 预期=None, 异常类型=None):
        try:
            值 = 动作()
        except Exception as 异常:
            通过 = 异常类型 is not None and type(异常) is 异常类型
            结果.append({"case": 名称, "ok": 通过,
                            "exception": type(异常).__name__, "message": str(异常)})
        else:
            通过 = 异常类型 is None and type(值) is type(预期) and 值 == 预期
            结果.append({"case": 名称, "ok": 通过, "value": 值})

    with tempfile.TemporaryDirectory(prefix="ini-lab-") as 临时目录:
        文件路径 = Path(临时目录) / "sample.ini"
        文件路径.write_text(默认配置, encoding="utf-8")
        默认解析器 = 配置解析.ConfigParser()
        字符串解析器 = 配置解析.ConfigParser()
        字面解析器 = 配置解析.ConfigParser(interpolation=None)
        扩展解析器 = 配置解析.ConfigParser(interpolation=配置解析.ExtendedInterpolation())

        def 加载(解析器, 文件名):
            with 文件名.open(encoding="utf-8") as 流:
                解析器.read_file(流)
            return 解析器.sections()

        检查("read_file accepts bad percent", lambda: 加载(默认解析器, 文件路径), ["app"])
        检查("read_string accepts bad percent", lambda: 字符串解析器.read_string(默认配置))
        检查("get rejects bad percent", lambda: 默认解析器.get("app", "bad"),
              异常类型=配置解析.InterpolationSyntaxError)
        检查("read_string get also rejects", lambda: 字符串解析器.get("app", "bad"),
              异常类型=配置解析.InterpolationSyntaxError)
        检查("raw returns percent", lambda: 默认解析器.get("app", "bad", raw=True), "80%")
        检查("raw does not change parser", lambda: 默认解析器.get("app", "bad"),
              异常类型=配置解析.InterpolationSyntaxError)
        检查("escaped percent", lambda: 默认解析器.get("app", "escaped"), "80%")
        检查("raw preserves double percent", lambda: 默认解析器.get("app", "escaped", raw=True), "80%%")
        检查("normal reference", lambda: 默认解析器.get("app", "path"), "data/logs")
        检查("raw preserves reference", lambda: 默认解析器.get("app", "path", raw=True), "%(root)s/logs")
        检查("missing placeholder", lambda: 默认解析器.get("app", "missing"),
              异常类型=配置解析.InterpolationMissingOptionError)
        检查("loop depth", lambda: 默认解析器.get("app", "loop"), 异常类型=配置解析.InterpolationDepthError)
        检查("DEFAULT before fallback", lambda: 默认解析器.getint("app", "workers", fallback=9), 4)
        检查("missing option fallback", lambda: 默认解析器.get("app", "unknown", fallback="backup"), "backup")
        检查("fallback cannot hide interpolation", lambda: 默认解析器.get("app", "bad", fallback="backup"),
              异常类型=配置解析.InterpolationSyntaxError)
        检查("boolean false", lambda: 默认解析器.getboolean("app", "enabled"), False)
        检查("bool string trap", lambda: bool(默认解析器.get("app", "enabled")), True)
        检查("fallback cannot hide bad boolean", lambda: 默认解析器.getboolean("app", "badbool", fallback=False),
              异常类型=ValueError)
        检查("fallback cannot hide bad integer", lambda: 默认解析器.getint("app", "badint", fallback=9),
              异常类型=ValueError)
        加载(字面解析器, 文件路径)
        检查("None literal percent", lambda: 字面解析器.get("app", "bad"), "80%")
        检查("None preserves reference", lambda: 字面解析器.get("app", "path"), "%(root)s/logs")
        检查("None preserves double percent", lambda: 字面解析器.get("app", "escaped"), "80%%")
        文件路径.write_text(扩展配置, encoding="utf-8")
        加载(扩展解析器, 文件路径)
        检查("Extended cross section", lambda: 扩展解析器.get("app", "path"), "data/logs")
        检查("Extended escaped dollar", lambda: 扩展解析器.get("app", "price"), "$80")
        检查("Extended bad dollar", lambda: 扩展解析器.get("app", "bad"), 异常类型=配置解析.InterpolationSyntaxError)
        检查("Extended literal percent", lambda: 扩展解析器.get("app", "percent"), "80%")
        检查("Extended leaves Basic syntax", lambda: 扩展解析器.get("app", "old"), "%(root)s/logs")

    通过数 = sum(项["ok"] for 项 in 结果)
    print(json.dumps({"python": sys.version.split()[0], "total": len(结果),
                      "passed": 通过数, "failed": len(结果) - 通过数,
                      "cases": 结果}, ensure_ascii=False, indent=2))
    if 通过数 != len(结果):
        raise SystemExit(1)


if __name__ == "__main__":
    主流程()
8. 验收清单与官方依据
本地实验通过,只能说明这组夹具在受测解释器上的行为符合预期。接入真实项目时,仍要列出所有必读选项:逐项取值、转换类型、核对引用展开后的结果,再检查取值范围、路径含义和消费方约定。尤其不能把未展开的占位字符串当作合法目录传下去,等后续文件操作失败才回来找原因。
收尾时逐条确认:解析器策略符合配置契约;正常引用确实展开;字面符号输出正确;默认项与缺失项分别核验;类型错误明确失败;原始读取不会改变后续行为。本文在隔离文件中验证标准库行为,不把这些结果写成生产系统已经通过验收。
事实依据来自 Python 官方 configparser 文档与 CPython v3.14.3 源码。前者解释默认插值、原始值、扩展插值和默认值优先级;后者可以核对 get 的分支、插值异常和类型转换的兜底范围。实际项目若使用其他版本或自定义转换器,应按自己的运行环境重新执行这些检查。
- 确认字面值与插值模式,禁止盲目全局替换。
- 同时覆盖正常取值、缺失、坏引用、循环和类型错误。
- 真实配置另做范围与消费方验收,不据本实验改生产。
🔕 评论已关闭