一、列表没有丢,只是被当成了一个值
给搜索接口拼查询参数时,常见需求是同时传两个标签。把列表放进字典再调用 urlencode,看着像是多选,解析回来却只有一个带方括号、引号的字符串。问题通常不在中文,也不是列表被网络弄丢了,而是编码时没有声明要展开多值。本文用 Python 3.14.3 做本地实验,最后交付可直接运行的完整代码,不向外部服务发请求。
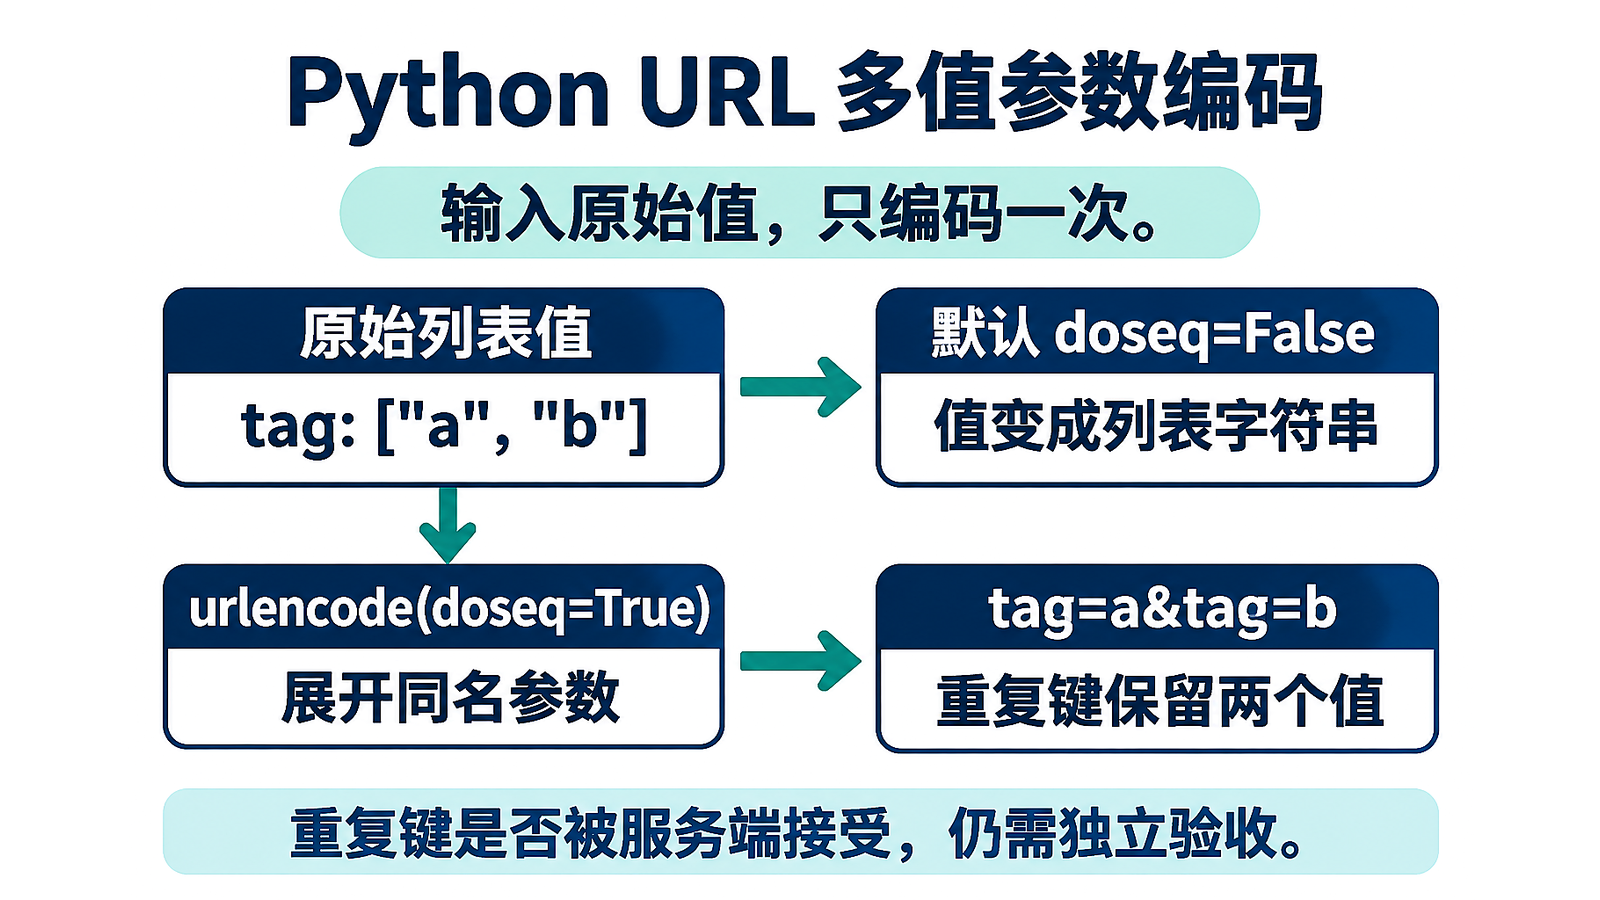
先别急着把方括号删掉。默认 doseq=False 时,列表会先被转成字符串,再作为一个参数值编码;即使把结果解码,得到的也只是列表的文字表示,并没有恢复成真正的多个字段。对照 CPython 源码里非展开分支的 str(v),就能解释这个现象。[2]
这里讨论的是查询串的数据结构,不是 JSON 请求体。若接口文档要求重复的 tag 字段,目标应是 tag=a&tag=b;若要求 JSON 数组或逗号分隔,那是另一套协议。不能仅凭客户端展开成功,就断言对方会接受,先确认接口约定再决定编码形态。
二、doseq 展开的是值,不是把所有对象拆开
对字符串列表使用 doseq=True,会为每个元素生成同名键值对。输入本身可以是映射,也可以是二元组序列;需要明确保留重复键时,后者更直观。官方文档明确说明了序列值的展开方式,以及输出参数顺序与输入二元组顺序的对应关系。[1]
不要把展开理解成逐字符遍历一切。字符串值有专门分支,ab 仍然是一个值;元组值则可以展开为多个值。空列表没有元素,因此不产生字段,和空字符串生成 q= 完全不同。这两种状态在筛选、清空条件时可能有不同业务含义,别为了省事都改成空字符串。[2]
None 也不是自动省略的开关:本次版本中,它会变成字面字符串 None。下文业务函数另外约定 None 代表省略,空串照常保留,多值只接受字符串列表或元组,数字和嵌套对象直接拒绝。这是示例主动收窄的接口,不是标准库只支持这些类型。
三、先分清空格、加号和中文
urlencode 默认调用 quote_plus:空格写成加号,原值里的加号写成 %2B。两者长得像,含义却不同。把 a+b 当作原始内容传入后,编码结果应包含 %2B;如果直接把加号塞进已经拼好的查询串,再按表单规则解析,就可能读成空格。[1]
中文字符串默认按 UTF-8 转为字节,再变成百分号编码。代码里显式写出 encoding 和严格错误策略,是为了让业务边界更容易看清。值里的 &、斜线、井号、等号都应交给编码器处理,换行会保留为编码后的数据,不能让它们意外变成字段分隔或片段标记。
若协议明确要求空格使用 %20,可以传 quote_via=quote;这个参数从 Python 3.5 才加入。还要注意 urlencode 会传递自己的 safe 参数,默认是空串,所以本例换成 quote 后,斜线仍编码为 %2F。不要把单独调用 quote 时的默认安全字符,直接套到这个组合调用上。[1][2]
四、只传原始值,编码一次就够了
业务层应保存原始内容,例如中文、空格、字面加号,而不是提前准备好百分号编码。先 quote 再 urlencode 时,第一次产生的百分号会在第二次变成 %25;解析一遍只能得到第一次的编码文本,并不会神奇地回到最初内容。实验用 a+b 对照这个差别,避免只看浏览器地址栏猜结果。
也别把整条 URL 交给 quote。协议头、路径、问号和查询串各有结构职责,整条处理可能把冒号、问号一起变成数据。反过来,保留部分符号也不等于完成了正确组装。这里先对键和值编码,再把得到的查询串放进 query 位置,让结构和数据各走各的路。
看见 %25 不必立刻判定双编码:用户原值本来就可能包含 %2B 这样的文字。判断依据是业务原值经过一次解析能否还原,而不是某个字符是否出现。更不能靠反复解码直到看起来顺眼,这会把字面数据误解释成控制符,掩盖上游传值错误。
五、保留多值时,别急着转 dict
解析重复键,优先看 parse_qsl 返回的键值对列表,并设置 keep_blank_values=True 保留空值。例如 tag=a&page=1&tag=b,可以保留三对数据的交错顺序。若马上转成 dict,同名键只剩后一个值,编码阶段认真保留下来的信息,转眼又在数据整理阶段被覆盖了。[1][2]
parse_qs 并不是不能处理多值,它会把同一键的值归到一个列表。区别在于按键聚合后,原来的全局交错顺序不再存在;重新编码时,两个 tag 会挨在一起。若只关心每个键有哪些值,这种结构很好用;若关心所有参数对的相对位置,就继续保留二元组列表。
六、固定基础网址,只替换查询部分
完整示例只使用固定可信的 https://example.org/search,通过 urlsplit 拆分后调用 _replace(query=查询串).geturl()。另一个用例专门放入旧查询和 fragment,验证旧 query 被替换,片段仍保留。这里没有自动追加旧参数的逻辑,需要追加时必须先明确合并规则,不能靠字符串拼接凑出来。
urlsplit 是结构拆分工具,不是完整 URL 安全校验器;本例也不接受用户传入任意基础网址。解析再组装可能规范化某些表现形式,所以这套写法不用于要求精确保留原始字节的签名协议。鉴权参数、重定向地址和签名规范仍需单独设计,不能把可解析当成可信。
七、完整代码与二十四项本地检查
下面只有一个代码块,保存为 example.py 后用 Python 3.14.3 运行即可。每项检查都采用显式比较或异常,不依赖 assert;失败会记录原因并以非零状态退出。代码只调用标准库处理内存字符串,没有 HTTP 客户端、网络连接或文件写入,也不需要安装依赖。
实验覆盖列表默认字符串化、多值展开、中文、空格、加号、保留符、换行、空值、重复键和非法输入。构建母稿时,还会从最终 HTML 提取同一代码块,逐字节核对后分别在默认、-O 和 -OO 模式执行。优化模式只用于重复确认检查不会消失,不算新增独立用例。
# -*- coding: utf-8 -*-
"""仅在内存中检查查询参数;不发送 HTTP 请求,不写文件。"""
import json
import sys
from urllib.parse import parse_qs, parse_qsl, quote, urlencode, urlsplit


基础网址 = "https://example.org/search"


def 规范化(参数):
    # 本文业务约定:键和值使用原始字符串,None 省略,列表或元组展开。
    if not isinstance(参数, (list, tuple)):
        raise TypeError("参数必须是二元组列表或元组")
    结果 = []
    for 项 in 参数:
        if not isinstance(项, tuple) or len(项) != 2:
            raise TypeError("每项必须是二元组")
        键, 值 = 项
        if not isinstance(键, str):
            raise TypeError("键必须是字符串")
        if 值 is None:
            continue
        if isinstance(值, str):
            结果.append((键, 值))
        elif isinstance(值, (list, tuple)):
            if any(not isinstance(元素, str) for 元素 in 值):
                raise TypeError("多值元素必须全部是字符串")
            结果.append((键, 值))
        else:
            raise TypeError("值只允许字符串、字符串列表或元组、None")
    return 结果


def 生成网址(参数):
    查询串 = urlencode(规范化(参数), doseq=True, encoding="utf-8", errors="strict")
    # 固定可信基础网址;这里替换 query,不自动合并已有查询串。
    return urlsplit(基础网址)._replace(query=查询串).geturl()


def 相等(实际, 预期):
    if 实际 != 预期:
        raise RuntimeError(f"实际 {实际!r};预期 {预期!r}")
    return 实际


def 拒绝(操作, 异常类型=TypeError):
    try:
        操作()
    except 异常类型:
        return "已按约定拒绝"
    raise RuntimeError("非法输入未被拒绝")


def 列表默认():
    查询串 = urlencode({"tag": ["python", "网络"]})
    return 相等(parse_qsl(查询串), [("tag", "['python', '网络']")])


def 展开列表():
    return 相等(urlencode({"tag": ["python", "网络"]}, doseq=True),
                "tag=python&tag=%E7%BD%91%E7%BB%9C")


def 中文():
    return 相等(urlencode({"q": "中文"}), "q=%E4%B8%AD%E6%96%87")


def 空格():
    return 相等(urlencode({"q": "a b"}), "q=a+b")


def 加号():
    return 相等(urlencode({"q": "a+b"}), "q=a%2Bb")


def 保留符():
    return 相等(urlencode({"q": "&/#="}), "q=%26%2F%23%3D")


def 换行():
    查询串 = urlencode({"q": "甲\n乙"})
    相等(查询串, "q=%E7%94%B2%0A%E4%B9%99")
    return 相等(parse_qsl(查询串), [("q", "甲\n乙")])


def 空串():
    查询串 = urlencode({"q": ""}, doseq=True)
    相等(查询串, "q=")
    相等(parse_qsl(查询串), [])
    return 相等(parse_qsl(查询串, keep_blank_values=True), [("q", "")])


def 空列表():
    return 相等(urlencode({"q": []}, doseq=True), "")


def 原生空值():
    return 相等(urlencode({"q": None}, doseq=True), "q=None")


def 业务空值():
    return 相等(生成网址([("跳过", None), ("q", ""), ("tag", [])]),
                "https://example.org/search?q=")


def 双重编码():
    原值 = "a+b"
    查询串 = urlencode({"q": quote(原值, safe="")})
    相等(查询串, "q=a%252Bb")
    return 相等(parse_qsl(查询串), [("q", "a%2Bb")])


def 整网址编码():
    错误网址 = quote("https://example.org/search?q=a+b", safe="")
    相等(错误网址, "https%3A%2F%2Fexample.org%2Fsearch%3Fq%3Da%2Bb")
    return 相等(urlsplit(错误网址).scheme, "")


def 字符串不拆():
    return 相等(urlencode({"q": "ab"}, doseq=True), "q=ab")


def 元组展开():
    return 相等(urlencode({"tag": ("a", "b")}, doseq=True), "tag=a&tag=b")


def 更换编码器():
    # urlencode 把自己的 safe='' 传给 quote,斜线仍然编码。
    return 相等(urlencode({"q": "a b/+"}, quote_via=quote), "q=a%20b%2F%2B")


def 重复对顺序():
    参数 = [("tag", "a"), ("page", "1"), ("tag", "b")]
    查询串 = urlencode(参数, doseq=True)
    相等(查询串, "tag=a&page=1&tag=b")
    return 相等(parse_qsl(查询串, keep_blank_values=True), 参数)


def 字典丢重复():
    参数 = parse_qsl("tag=a&page=1&tag=b", keep_blank_values=True)
    return 相等(dict(参数), {"tag": "b", "page": "1"})


def 按键聚合():
    分组 = parse_qs("tag=a&page=1&tag=b", keep_blank_values=True)
    相等(分组, {"tag": ["a", "b"], "page": ["1"]})
    return 相等(urlencode(分组, doseq=True), "tag=a&tag=b&page=1")


def 替换旧查询():
    网址 = urlsplit("https://example.org/search?old=1#section")
    return 相等(网址._replace(query=urlencode({"q": "a b"})).geturl(),
                "https://example.org/search?q=a+b#section")


def 拒绝参数容器():
    for 参数 in ({"q": "a"}, "q=a", None):
        拒绝(lambda 参数=参数: 规范化(参数))
    return "三种不符合业务接口的容器均已拒绝"


def 拒绝非法元素():
    for 参数 in ([("q",)], [(1, "a")], [("q", 0)],
                 [("q", ["a", None])], [("q", {"a"})]):
        拒绝(lambda 参数=参数: 规范化(参数))
    return "五种非法项均已拒绝;不自动把数字或嵌套对象转字符串"


def 标准库拒绝():
    return 拒绝(lambda: urlencode("q=a"))


def 原值往返():
    参数 = [("q", "中文 +&/#=\n%2B"), ("tag", ["a+b", "", "中文"])]
    网址 = 生成网址(参数)
    相等(网址.startswith(基础网址 + "?"), True)
    相等(parse_qsl(urlsplit(网址).query, keep_blank_values=True),
         [("q", "中文 +&/#=\n%2B"), ("tag", "a+b"), ("tag", ""), ("tag", "中文")])
    return 网址


def 主程序():
    用例 = [
        ("列表默认变为一个字符串", 列表默认), ("doseq 展开列表", 展开列表),
        ("中文使用 UTF-8", 中文), ("空格变加号", 空格),
        ("字面加号编码", 加号), ("保留符编码", 保留符),
        ("换行编码往返", 换行), ("空串与保留空值", 空串),
        ("空列表不产字段", 空列表), ("None 原生字符串化", 原生空值),
        ("业务显式省略 None", 业务空值), ("先 quote 导致双编码", 双重编码),
        ("整网址 quote 破坏结构", 整网址编码), ("字符串不按字符展开", 字符串不拆),
        ("元组值展开", 元组展开), ("quote_via 使用 %20 表示空格", 更换编码器),
        ("重复键与交错顺序", 重复对顺序), ("dict 丢失重复键", 字典丢重复),
        ("parse_qs 按键聚合", 按键聚合), ("替换旧 query 并保留 fragment", 替换旧查询),
        ("业务拒绝非法容器", 拒绝参数容器), ("业务拒绝非法元素", 拒绝非法元素),
        ("urlencode 拒绝非法输入", 标准库拒绝), ("原始字符串组合往返", 原值往返),
    ]
    失败数 = 0
    for 序号, (名称, 操作) in enumerate(用例, 1):
        try:
            观察 = 操作()
        except Exception as 错误:
            失败数 += 1
            记录 = {"序号": 序号, "用例": 名称, "状态": "失败", "错误": str(错误)}
        else:
            记录 = {"序号": 序号, "用例": 名称, "状态": "通过", "观察": 观察}
        print(json.dumps(记录, ensure_ascii=False))
    print(json.dumps({"总数": len(用例), "通过": len(用例) - 失败数,
                      "失败": 失败数, "边界": "仅内存标准库语义;未发送 HTTP 请求"}, ensure_ascii=False))
    return 1 if 失败数 else 0


if __name__ == "__main__":
    sys.exit(主程序())
八、按现象定位,再按契约验收
排查时先保存编码前的原值和编码后的查询串,再用明确的解析选项对照。别只盯着地址栏里显示了什么,也不要看到参数数量对了就宣布业务成功。下面的故障表对应本地能复现的语义;真实框架如何接收重复键、是否拒绝空串、怎样解释换行,需要在目标系统另做集成测试。
本次检查证明的是指定解释器下的编码、解析与组装行为,不是服务端兼容性、签名正确性或权限验收。实际接入时,最重要的仍是把原值类型、多值格式、空值策略和顺序要求写进接口契约。客户端做对一半不难,难的是别替另一个系统擅自补上剩下的一半。
| 现象 | 本地原因 | 处理方向 |
|---|---|---|
| 解析后是带方括号的字符串 | 默认把列表当成单个值 | 接口要求重复键时使用 doseq=True |
| 加号被读成空格 | 手工拼接查询串或混淆编码层 | 把字面加号作为原始值交给 urlencode |
| 一次解析后仍出现 %2B | 可能先 quote 再 urlencode | 和原值对照;字面 %2B 不应误修 |
| 空字段消失 | 空列表无元素,或解析时忽略空串 | 区分 [] 和空串;按需保留空值 |
| 重复键只剩最后一个 | 把键值对列表转成 dict | 保留 parse_qsl 的列表结构 |
| 旧参数不见了 | _replace 替换整个 query | 按业务规则明确合并,不冒称自动追加 |
验收清单
- 接口明确要求重复同名字段,而非 JSON 或逗号拼接。
- 业务层只传原始字符串,并明确 None、空串、空列表三种状态。
- 中文、空格、字面加号和保留符一次编码、一次解析可还原。
- 确需保序时保留键值对列表,没有转 dict 或无意按键聚合。
- 固定可信基础网址;旧 query 的替换行为和 fragment 保留符合预期。
- 本地语义检查通过后,另做目标服务的参数、签名与鉴权集成验收。
🔕 评论已关闭