把甲、乙、甲三条记录交给groupby,得到甲组、乙组、甲组,看起来像相同标签没有归到一起。问题往往不在数据丢失,而在我们把连续分段当成了全局收集。遇到这个现象,我更愿意先把输入顺序和每条记录的分组键打印出来,再讨论怎么改。 同一个名称可以在结果中出现多次。末尾那条甲记录前面隔着乙,已经不属于开头那段。若需求是识别连续状态,这个结果正合适;若需求是把所有甲放在一个容器里,就要额外选择排序归并或字典累积,不能只换一个变量名。 官方定义强调连续的键和组。这里的键不是字段名称本身,而是key函数对每条元素计算的结果。扫描过程中,键一变化就进入下一组;后面再次出现相等的键,也不会自动回头查找旧组。未指定key时,直接用元素自身作为键。 因此,排序不是调用groupby的强制前置条件。原顺序有意义时,直接分段才是正确语义。只有目标变成全局归类,且允许重排输入,才适合先让同键记录相邻。下文限定普通有限输入和纯确定性键函数,不讨论自定义异常比较、无限流或并发读取。 先按标签排序,再按标签分组,能把这个例子里相同标签的记录放到一起。最容易漏掉的是两步必须采用一致的键口径:按序号排序、按标签分组,甲乙甲仍可能原样出现。不能看到代码里有sorted,就认定输入已经满足同键相邻的条件。 排序是稳定的,相等排序键的记录保留原来的相对顺序。因此只按标签排序后,两条甲记录仍按原先的先后排列。但稳定不等于全局事件顺序不变;不同标签之间已经重排。若后续逻辑依赖原始事件顺序,应保留原数据,另行选择归类方式。 sorted会先消费输入并建立新列表,不能把它看成零成本的流式补丁。大小写不敏感时,排序和分组都用casefold,才能统一键口径。只在分组阶段忽略大小写,前面的默认字符排序仍可能把本该同组的字符串隔开,实验里保留了这个反例。 字典累积的思路是每次取出一条记录,计算键,再追加到对应列表。它不要求输入先相邻,也不要求键之间能比较大小。普通字典按首次遇到键的顺序保留桶的位置,各桶内部按到达顺序追加;这与按键排序后的组顺序不是一回事。 不要把累积误写成对groupby结果做字典推导。甲组先出现一次,后面又出现一次,相同字典键的后一次赋值会覆盖前一次。即使每个子组都及时转成列表,也只解决了子迭代器寿命,没有解决字典覆盖。真正的累积需要追加,而不是重新赋值。 字典键必须可哈希,列表不能直接当键。groupby只需比较连续键是否相等,因此实验中的列表键仍可分段。两条路线也都不天然省内存:完整保存所有桶要保留全部记录的引用;排序再全部转列表,同样会把结果留在内存里,不能宣传成大数据通用方案。 groupby外层与返回的子组共享底层输入。把所有键和子迭代器先收集起来,稍后再遍历子组,旧组通常已经耗尽。需要稍后使用内容,就在当前组仍有效时立即调用list。这里保存的是组内容,不是给同一个底层游标增加一份独立的读取进度。 部分读取尤其值得单独检查。只读当前组的第一项便推进外层,外层会跳过旧组剩余元素以找到下一个键。这个时候再读取旧组,不能期待补回刚才跳过的部分。生成器也只有一遍游标;第一次分组或排序消费完之后,再次遍历不会自动重放。 转成列表仍不是深复制。组里放的是原对象的引用,后续修改某个可变对象,其变化也能通过组列表看到。若确实需要独立快照,要另行定义复制深度和对象范围;不要把list误当作不可变历史记录,本文的实验也只验证引用关系。 先决定键的含义,再决定用什么容器。零和False按Python的相等语义会合到一起,字典也有相同现象。若业务确实要区分类型,可以让类型标识参与键;这里仅展示一种明确口径,不把它当成所有数据模型的默认答案。 None与字符串、数字与字符串不能在示例中直接混排。示例为缺失标签定义了一个元组键,把缺失值放在后面,并限定其余值都是字符串。不要把全部值随手转成字符串来消除报错,那可能掩盖原本应该区分的类型和缺失值。 键函数抛异常时,异常会向外传播,源游标却没有事务式回滚。触发异常的元素已经取出,重试策略需要调用方另行设计。下面只检查异常传播及剩余输入,不承诺旧子组能在异常后恢复,也不拿局部实验推断外部系统的处理结果。 将下面整个代码块保存为example.py,用Python执行。它只依赖标准库,输入都是很小的有限样本,不读写业务文件。每项检查用显式条件和异常拒绝错误结果,不把assert当作唯一门禁,所以优化运行时也不会悄悄删掉验收逻辑。 本稿的代码已在Python 3.14.3下以默认、-O、-OO三种模式重放。实际通过数由结果列表计算并输出,不手填成功数字。读者修改样本后,应同时修改明确的预期值;只看脚本有没有报错,不足以判断分组语义是否符合自己的需求。 验收时先看语义,再看完整性和顺序。下面的清单只适用于这个本地有限输入实验,不能替代数据库聚合、SQL执行计划、外部服务或并发场景的验收。实际数据量变大时,还要另测峰值内存和耗时,不能从几条样本推导容量结论。 我的选择顺序是:需要连续状态段就直接分组;允许重排且需要按键输出,就使用同键排序;不需要按键排序而要收齐同名项,就逐条累积。最后再核对键的归一化规则和保存方式。把这些问题说清楚,比记住一个固定写法更可靠。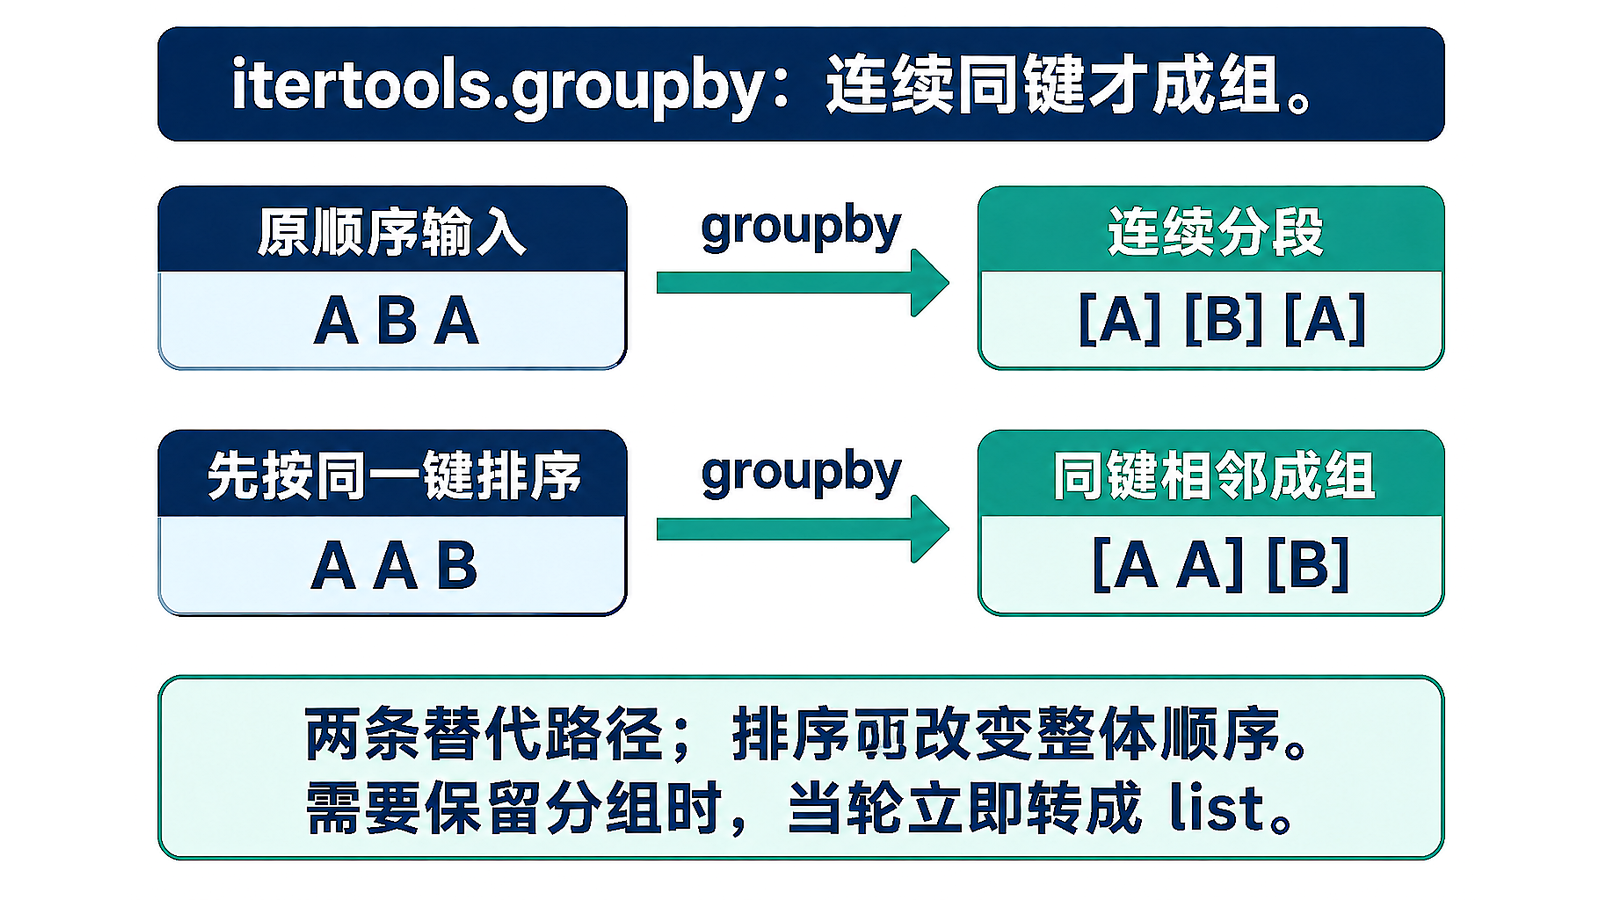
一、同名记录为什么变成三组
二、先确定要连续分段还是全局归类
三、需要全局归并时,两步使用同一键
四、不想排序,就逐项放入字典桶
五、先保存组内容,别只保存组迭代器
六、把边界问题写进故障表
现象 原因 检查方向 同名项分成多组 同键在输入中不连续 确认要分段还是全局归类 排过序仍然拆组 排序键与分组键口径不同 两步复用同一键函数 稍后读取子组为空 共享源已被外层推进 在当前组即时list 只剩最后一段同名项 字典赋值覆盖早组 逐条追加到桶 排序抛出类型错误 键之间不能直接比较 明确缺失和类型排序规则 七、复制一个脚本,检查结果而非只看输出
from itertools import groupby
import json

结果 = []
def 检查(名称, 实际, 预期):
    if 实际 != 预期:
        raise RuntimeError(f"{名称}:{实际!r} != {预期!r}")
    结果.append({"用例": 名称, "通过": True})

def 查异常(名称, 操作, 异常类型):
    try:
        操作()
    except 异常类型:
        检查(名称, True, True)
    else:
        raise RuntimeError(f"{名称}:未抛出{异常类型.__name__}")

def 分段(数据, 键=None):
    return [(值, list(组)) for 值, 组 in groupby(数据, key=键)]

def 累积(数据, 键):
    桶 = {}
    for 项 in 数据:
        桶.setdefault(键(项), []).append(项)
    return 桶

记录 = [("甲", 1), ("乙", 2), ("甲", 3)]
取键 = lambda 项: 项[0]
原段 = 分段(记录, 取键)
检查("非连续同键拆段", [键 for 键, 组 in 原段], ["甲", "乙", "甲"])
排后 = sorted(记录, key=取键)
检查("同键排序后归并", 分段(排后, 取键),
     [("乙", [("乙", 2)]), ("甲", [("甲", 1), ("甲", 3)])])
检查("组内稳定顺序", dict(分段(排后, 取键))["甲"], [记录[0], 记录[2]])
检查("全局事件顺序改变", 排后 == 记录, False)
检查("按序号排序仍拆段", 分段(sorted(记录, key=lambda 项: 项[1]), 取键), 原段)
检查("即时列表保留内容", 分段("甲甲乙"), [("甲", ["甲", "甲"]), ("乙", ["乙"])])
延迟 = list(groupby("甲甲乙"))
检查("延迟子迭代器耗尽", [list(组) for 键, 组 in 延迟], [[], []])
覆盖 = {键: list(组) for 键, 组 in groupby(记录, key=取键)}
检查("字典覆盖早先同键组", 覆盖["甲"], [记录[2]])
桶 = 累积(记录, 取键)
检查("字典累积不丢记录", 桶, {"甲": [记录[0], 记录[2]], "乙": [记录[1]]})
检查("字典首次见键顺序", list(桶), ["甲", "乙"])
检查("空输入", 分段([]), [])
检查("单项输入", 分段(["甲"]), [("甲", ["甲"])])
检查("全部同键", 分段("甲甲甲"), [("甲", ["甲"] * 3)])
词 = ["a", "B", "A"]
统一键 = str.casefold
检查("只在分组时统一键仍拆段", len(分段(sorted(词), 统一键)), 3)
检查("排序分组统一casefold", 分段(sorted(词, key=统一键), 统一键),
     [("a", ["a", "A"]), ("b", ["B"])])
查异常("None与字符串不可直接排序", lambda: sorted([None, "甲"]), TypeError)
查异常("数字与字符串不可直接排序", lambda: sorted([1, "1"]), TypeError)
# 缺失值排后,非缺失值限定为字符串;两步使用同一键。
缺失键 = lambda 项: (项 is None, "" if 项 is None else 项)
检查("显式定义缺失值顺序", 分段(sorted([None, "甲", None], key=缺失键), 缺失键),
     [((False, "甲"), ["甲"]), ((True, ""), [None, None])])
检查("零与假按相等语义合组", len(分段([0, False, 0])), 1)
检查("字典也合并零与假", len(累积([0, False], lambda 项: 项)), 1)
类型键 = lambda 项: (type(项).__name__, 项)
检查("类型参与键才能区分", len(累积([0, False], 类型键)), 2)
源 = (项 for 项 in "甲乙甲")
检查("生成器首次消费", len(分段(源)), 3)
检查("生成器不能重放", 分段(源), [])
源 = (项 for 项 in "乙甲")
排后 = sorted(源)
检查("排序已消费生成器", (排后, list(源)), (["乙", "甲"], []))
外层 = groupby("甲甲乙乙")
键, 组 = next(外层)
检查("部分读取首项", next(组), "甲")
次键, 次组 = next(外层)
检查("推进外层丢弃旧组余项", (list(组), 次键, list(次组)), ([], "乙", ["乙", "乙"]))

def 拒绝零(数):
    if 数 == 0:
        raise ValueError("零没有分组键")
    return 数

源 = iter([1, 0, 2])
外层 = groupby(源, key=拒绝零)
键, 组 = next(外层)
检查("异常前可读首项", next(组), 1)
查异常("键异常向外传播", lambda: next(组), ValueError)
检查("异常不回滚源游标", list(源), [2])
对象 = {"标签": "甲", "值": 1}
保留 = 分段([对象], lambda 项: 项["标签"])
对象["值"] = 9
检查("组内元素仍为原引用", (保留[0][1][0] is 对象, 保留[0][1][0]["值"]), (True, 9))
检查("列表键可连续分组", 分段([1, 1], lambda 项: [项]), [([1], [1, 1])])
查异常("字典键必须可哈希", lambda: 累积([1], lambda 项: [项]), TypeError)
print(json.dumps({"通过数": len(结果), "用例": 结果}, ensure_ascii=False))
八、验收清单与官方参考
🔕 评论已关闭