SQLite 已经启用 WAL,Python 服务却仍报 database is locked;把 timeout 调大,有些请求还是立刻失败。问题未必是连接太多,而可能是读事务拿着旧快照,想半路变成写事务。下面用本地双连接实验,区分“写者占用”和“快照过期”,再把重试放回正确位置。
一、WAL 允许读写并行,不等于多人同时写
WAL 将变更追加到日志,读者可以继续查看自己的已提交快照;但同一数据库同一时刻仍只有一个写事务。它改善读写相互阻塞,不会把单写者变成多写者。本文限定同机、本地文件系统、独立连接,不讨论 shared-cache 特例;不要照搬到多机共享网络盘。
在实际连接查询 PRAGMA journal_mode; 和 PRAGMA busy_timeout;;记录路径、事务时长和连接标识,排除错库与长事务。只查模式,不在生产直接切换。
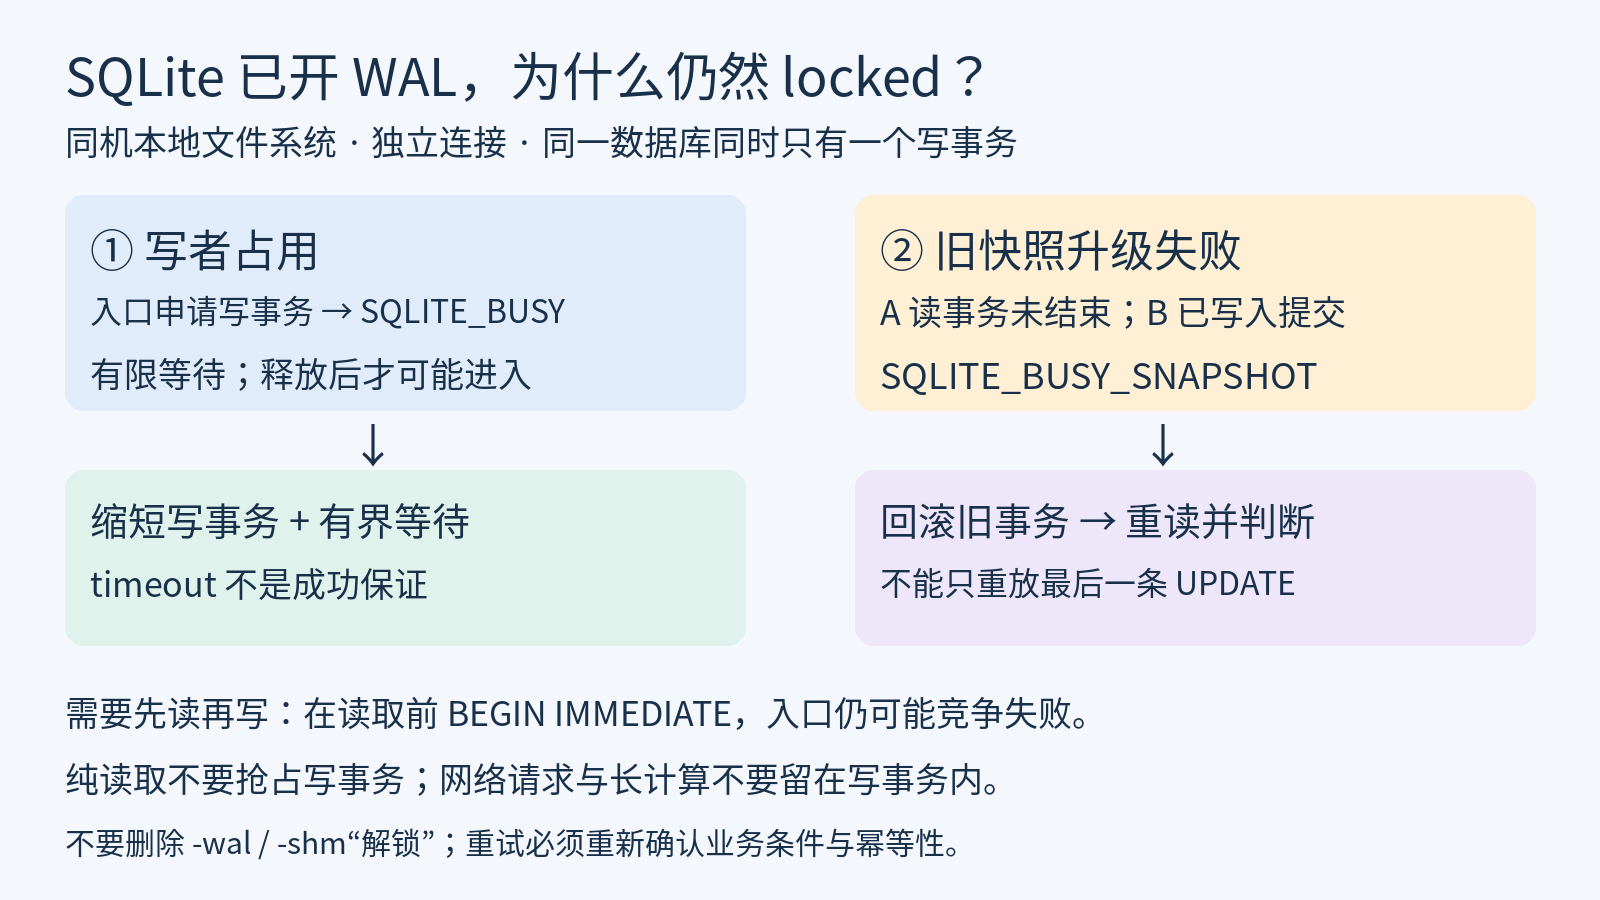
二、为什么有些 locked 等一等也没用
普通写竞争是“写入位置被别人占用”,对方及时结束后可能继续。另一种顺序是:A 开始事务并读取;B 修改并提交;A 再写。A 的快照落后,升级会返回 SQLITE_BUSY_SNAPSHOT,它是 BUSY 的扩展码。等待不会更新旧快照。
Python 3.11 起,SQLite 异常可提供 sqlite_errorcode 与 sqlite_errorname。记录符号名、失败阶段和事务状态,不只记错误文本;日志不带业务数据或凭据。
三、用两个连接复现,不碰业务库
保存为 demo.py,用 Python 3.12+ 执行 python3 demo.py。临时独立库用完清理;autocommit=True 配合 SQL 显式控制事务。
import sqlite3
from pathlib import Path
from tempfile import TemporaryDirectory
from contextlib import closing

with TemporaryDirectory() as d:
    path = Path(d) / "demo.db"
    with closing(sqlite3.connect(path, autocommit=True)) as a, \
         closing(sqlite3.connect(path, autocommit=True)) as b:
        assert a.execute("PRAGMA journal_mode=WAL").fetchone()[0] == "wal"
        a.execute("CREATE TABLE counter(n INTEGER)")
        a.execute("INSERT INTO counter VALUES(0)")
        a.execute("BEGIN")
        print("旧快照", a.execute("SELECT n FROM counter").fetchone()[0])
        b.execute("UPDATE counter SET n=n+1")
        try:
            a.execute("UPDATE counter SET n=n+1")
        except sqlite3.OperationalError as e:
            print(e.sqlite_errorname)
        finally:
            a.execute("ROLLBACK")
        a.execute("BEGIN IMMEDIATE")
        try:
            n = a.execute("SELECT n FROM counter").fetchone()[0]
            a.execute("UPDATE counter SET n=?", (n + 1,))
            a.execute("COMMIT")
        except Exception:
            if a.in_transaction:
                a.execute("ROLLBACK")
            raise
        print("重新读取后", a.execute("SELECT n FROM counter").fetchone()[0])
本次 Python 3.14.3、SQLite 3.26.0 实测依次输出“旧快照 0”、SQLITE_BUSY_SNAPSHOT、“重新读取后 2”。值 2 包含 B 和 A 各一次加一,而非旧值覆盖。这是语义实验,不是吞吐测试,也不建议部署旧版。
四、BEGIN IMMEDIATE 要放在读取之前
确定需要“先读再写”的短事务,可在任何业务读取之前执行 BEGIN IMMEDIATE,提前申请写事务。其他写者存在时,它仍可能失败;它把竞争移到入口,不会消灭竞争。成功后再读取、检查条件、更新并提交,避免本例中读完才升级的窗口。
纯读取不应统一改用 IMMEDIATE,否则白占写入位置。网络请求、文件上传、长计算和等待用户输入也应移到事务外;移出后会变化的业务条件,必须在事务内重新检查。已有事务不能再次 BEGIN,先弄清 ORM 或驱动是否已自动开事务。
注意:本例设置 autocommit=True 后,Python 的 commit()、rollback() 方法不起作用,因此代码用 SQL 明确结束事务。不要只复制一半配置,再把另一半换成 ORM 的默认写法。
五、timeout 是等待策略,不是成功保证
sqlite3.connect(..., timeout=2.0) 以秒设置等待;PRAGMA busy_timeout=2000; 以毫秒设置当前连接的 busy handler。它不是整次请求的总超时,也不会保证任何锁错误都等待满两秒。连接池需要逐连接设置,一个连接的新 busy handler 会替换旧的。
出现 BUSY_SNAPSHOT 时,先结束旧事务,再从读取和业务判断开始有限重试;不要只重放最后一条 UPDATE。普通 BUSY 也须按失败阶段确定事务状态,不能直接循环 BEGIN。重试要有总预算、退避和次数上限;唯一键冲突、磁盘满或权限错误不属于同一分支。
付款、通知等外部动作不能盲目重放,应结合幂等键、事务消息表设计。
六、按证据选择下一步
| 现象 | 优先处理 |
|---|---|
| BEGIN IMMEDIATE 返回 BUSY | 找占用写者,缩短事务并有限等待 |
| 读后写出现 BUSY_SNAPSHOT | 回滚旧快照,从读取开始重做 |
| cannot start a transaction | 检查隐式事务与重复 BEGIN |
| SQLITE_LOCKED | 排查同连接游标、未完成语句与共享缓存 |
| WAL 文件持续增大 | 检查长读事务与 checkpoint 进度 |
SQLITE_LOCKED 不要直接等同于 SQLITE_BUSY。长读事务会阻碍 checkpoint 推进,但 WAL 大小不是写锁持有时间的直接证据。不要删除 -wal、-shm 文件来“解锁”,其中可能有尚未回写主文件的已提交数据。
七、验收要看失败分支和业务值
- 确认实际连接处于 WAL,记录驱动与 SQLite 版本。
- 保留旧快照升级失败;回滚重读后确认值为 2。
- 让一个连接占住写事务:另一连接仍能读旧的已提交值,但第二个写者会竞争失败。
- 写者释放后再次进入成功;主动回滚后,其他连接不能看到未提交更新。
- 观察事务时长、等待时间、失败阶段和重试数,不只看错误是否消失。
隔离检查覆盖以上分支;生产仍需验证多进程、连接池和幂等性。持续并发写入若超出短事务与排队的能力,再评估客户端/服务器数据库。
八、参考与适用边界
依据 SQLite 官方的事务隔离、事务控制、busy timeout、WAL 说明以及 Python sqlite3 文档核对。这是长期排查方案,不是新功能。先定位事务阶段,别只加超时。
🔕 评论已关闭